Bambu Lab 製 3Dプリンターの稼働状況を Slack に通知する

「1つの3Dプリンターを複数人で共用する」という場面がありました。この時、Slackに稼働状況が通知されることで「今、プリンターがどんな状況か」をSlack上で把握できるようになっていると各人が3Dプリンターを使いやすくなるかなと思い、作ってみました。
この3つのタイミングで通知をしています。
- プリント開始時 / プリントにかかる時間とプリントの終了時間の目安
- プリント終了時
- なんらかの理由で停止した時

リポジトリはこちらです。
仕組み
プログラムはマイコンにArduinoで書き込んでいます。このマイコンは給電が必要なので電源につないでおきます。

マイコンと3Dプリンターを同一ネットワークに繋ぐことで、MQTTプロトコルを介して3Dプリンターの情報をjson形式で取得することができます。このとき、MQTTプロトコルに繋ぐために3Dプリンターの LAN Access Code などが必要になります。
  client.setServer(mqtt_server, 8883);
  client.setCallback(callback);
  client.setBufferSize(32768);
注意点として、jsonはcallbackを介して常に取得することができるのですが必ず同じ構造で返ってくるわけではないようです。プリントの開始時など、タイミングごとに追加されるデータがあったりなかったりするようです。
というのも、json形式の中のデータのフォーマットはおそらく公式で公開されておらず、実際のjsonの中身を見て判断したことになります。また、Bambu Lab 製のどのプリンターかによっても中身が違う可能性があります。
例えばプリンターの稼働状況はプリントの開始時や終了時などに gcode_state から取得することができるので、その切り替わりを検知して Slack に通知を流しています。
  JsonDocument doc;
  DeserializationError error = deserializeJson(doc, messageTemp);
  ...
  bool hasPrint = doc.containsKey("print");
  bool hasGcodeState = hasPrint && doc["print"].containsKey("gcode_state");
  bool hasRemainingTime = hasPrint && doc["print"].containsKey("mc_remaining_time");
  if (hasGcodeState) {
    String newState = doc["print"]["gcode_state"].as<String>(); // "RUNNING", "FAILED", "PAUSE", "FINISH" などが入る
    ...
ハマったところ
主に3つです。
Arduinoのプログラムを書き込む時に Tools -> Upload Speed を調整する必要がありました。これはケーブルやPCによる環境依存だと思います。自分の環境では 921600 -> 115200 としました。
次に、バッファサイズはsetBufferSize(32768)として大きめに確保しました。MQTT経由で取得できるjsonデータが大きいのと、前述のようにjsonデータの構造が場合によって異なるのでそれも加味して大きめにしています。
client.setBufferSize(32768);
最後に、 MQTT接続が state: 5(認証エラー)で失敗する場合はプリンター画面の LAN Access Code が異なっていることが問題の場合があります。LANモードの切り替えやファームウェア更新で再生成されることがあるようです。MQTT接続できているかどうかはArduinoのSerial Monitorから確認します。
コード
以下が全文です。 secrets.h を別途用意し、wifiなどの情報はそちらに記載しておきます。
bambu_slack_notifier.ino
#include <WiFi.h>
#include <WiFiClientSecure.h>
#include <PubSubClient.h>
#include <ArduinoJson.h>
#include <HTTPClient.h>
#include <time.h>
#include "secrets.h"

// ==========================================
// Config lives in secrets.h (copy secrets.example.h to create it)
// ==========================================
const char* ssid = WIFI_SSID;          // Wi-Fi SSID
const char* password = WIFI_PASSWORD;  // Wi-Fi password

const char* mqtt_server = MQTT_SERVER;      // Printer's local IP address
const char* mqtt_user = "bblp";               // Fixed as "bblp" on Bambu
const char* mqtt_password = MQTT_PASSWORD; // LAN Access Code from the printer screen
const char* mqtt_topic = MQTT_TOPIC; // device/<serial-number>/report

const char* slack_webhook_url = SLACK_WEBHOOK; // Slack Webhook URL
// ==========================================

// ==========================================
// Slack notification messages (edit freely / translate here)
// Static messages are plain constants; the dynamic "start" message is
// assembled in buildStartMessage() / formatDuration() below.
// ==========================================
const char* MSG_FINISH = "✅ プリントが正常に完了しました!";
const char* MSG_PAUSE  = "⚠️ プリントが一時停止、またはエラーが発生しました。";
// ==========================================

WiFiClientSecure espClient;
PubSubClient client(espClient);

String currentState = "UNKNOWN";
bool isStartNotified = false;

const long gmtOffset_sec = 32400; // JST (9 hours * 3600 sec)
const int daylightOffset_sec = 0;

// Send a message to Slack
void sendSlackMessage(String message) {
  // for debug
  // Serial.println("Slack notification preview:");
  // Serial.println(message);
  // return;

  if (WiFi.status() == WL_CONNECTED) {
    HTTPClient http;
    http.begin(slack_webhook_url);
    http.addHeader("Content-Type", "application/json");

    // Build the JSON payload
    String payload = "{\"text\":\"" + message + "\"}";

    int httpResponseCode = http.POST(payload);
    Serial.print("Slack POST result (HTTP code): ");
    Serial.println(httpResponseCode);
    http.end();
  }
}

// Format a duration in minutes, e.g. "2時間30分" / "30分".
// To translate, rewrite the returned strings (word order is free here).
String formatDuration(int totalMinutes) {
  int hours = totalMinutes / 60;
  int mins = totalMinutes % 60;
  if (hours > 0) {
    return String(hours) + "時間" + String(mins) + "分";
  }
  return String(mins) + "分";
}

// Build the whole "print started" message.
// finishTime is the expected finish time (e.g. "14:30"); empty to omit it.
// To translate, edit this function body in one place.
String buildStartMessage(int remainingMinutes, const String& finishTime) {
  String msg = "🚀 プリントを開始しました!\n合計推定時間: " + formatDuration(remainingMinutes);
  if (finishTime.length() > 0) {
    msg += "\n完了予定時刻: " + finishTime;
  }
  return msg;
}

void callback(char* topic, byte* payload, unsigned int length) {
  // for debug
  // Serial.print("[received] size: ");
  // Serial.println(length);

  String messageTemp;
  for (int i = 0; i < length; i++) {
    messageTemp += (char)payload[i];
  }

  JsonDocument doc;
  DeserializationError error = deserializeJson(doc, messageTemp);

  if (error) {
    // If the JSON is too large to parse, the buffer may be too small
    Serial.println("JSON parse error: payload size is too large");
    return;
  }

  // Check what the received payload contains
  bool hasPrint = doc.containsKey("print");
  bool hasGcodeState = hasPrint && doc["print"].containsKey("gcode_state");
  bool hasRemainingTime = hasPrint && doc["print"].containsKey("mc_remaining_time");

  // 1. Update the state (gcode_state)
  if (hasGcodeState) {
    String newState = doc["print"]["gcode_state"].as<String>();
    if (newState != currentState && currentState != "UNKNOWN") {
      Serial.println("State change detected: " + currentState + " -> " + newState);

      if (newState == "FINISH") {
        sendSlackMessage(MSG_FINISH);
        isStartNotified = false;
      } else if (newState == "PAUSE" || newState == "FAILED") {
        sendSlackMessage(MSG_PAUSE);
        isStartNotified = false;
      } else if (newState == "IDLE") {
        isStartNotified = false;
      }
    }
    currentState = newState;
  }

  // 2. Handle the start notification
  if (currentState == "RUNNING" && !isStartNotified) {
    if (hasRemainingTime) {
      int remainingTime = doc["print"]["mc_remaining_time"].as<int>();

      if (remainingTime > 0) {
        // Compute the expected finish time (empty if NTP not ready yet)
        String finishTime = "";
        time_t now;
        struct tm timeinfo;
        if (getLocalTime(&timeinfo)) {
          time(&now);
          now += (remainingTime * 60);
          struct tm *finish = localtime(&now);
          char timeStr[10];
          strftime(timeStr, sizeof(timeStr), "%H:%M", finish);
          finishTime = String(timeStr);
        }

        sendSlackMessage(buildStartMessage(remainingTime, finishTime));
        isStartNotified = true;
        Serial.println("Sent notification to Slack: " + formatDuration(remainingTime));
      }
    }
  }
}

void setup_wifi() {
  delay(10);
  Serial.println("\nConnecting to Wi-Fi...");
  WiFi.begin(ssid, password);

  while (WiFi.status() != WL_CONNECTED) {
    delay(500);
    Serial.print(".");
  }

  Serial.println("\nWiFi connected! IP:");
  Serial.println(WiFi.localIP());

  Serial.flush();
}

void reconnect() {
  // Loop until connected to MQTT
  while (!client.connected()) {
    Serial.print("Connecting to the Bambu printer's MQTT...");

    // Connect with an arbitrary client ID
    String clientId = "ESP32Client-";
    clientId += String(random(0xffff), HEX);

    if (client.connect(clientId.c_str(), mqtt_user, mqtt_password)) {
      Serial.println("connected!");
      client.subscribe(mqtt_topic);
    } else {
      Serial.print("failed, state: ");
      Serial.print(client.state());
      Serial.println(" retrying in 5 seconds...");
      delay(5000);
    }
  }
}

void setup() {
  Serial.begin(115200);

  setup_wifi();

  Serial.println("Step 1: Wi-Fi OK, waiting 1 sec...");
  Serial.flush();
  delay(1000);

  Serial.println("Step 2: NTP Time config...");
  Serial.flush();
  configTime(gmtOffset_sec, daylightOffset_sec, "ntp.nict.jp", "time.google.com");

  Serial.println("Step 3: MQTT setup...");
  Serial.flush();
  espClient.setInsecure();
  client.setServer(mqtt_server, 8883);
  client.setCallback(callback);
  client.setBufferSize(32768);

  Serial.println("Step 4: Setup complete!");
  Serial.flush();
}

void loop() {
  if (!client.connected()) {
    reconnect();
  }
  client.loop();
}
secrets.h
// secrets.example.h
// Copy this file to secrets.h and fill in the values for your environment:
//   cp secrets.example.h secrets.h
// secrets.h is excluded by .gitignore, so it is never committed.
#pragma once

// --- Wi-Fi ---
#define WIFI_SSID      "YOUR_WIFI_SSID"
#define WIFI_PASSWORD  "YOUR_WIFI_PASSWORD"

// --- Bambu printer (LAN) ---
// Printer IP address (printer screen: Settings > Network)
#define MQTT_SERVER    "192.168.x.x"
// LAN Access Code (printer screen: Settings > Network)
#define MQTT_PASSWORD  "XXXXXXXX"
// Subscribe topic. Fill in the serial number (SN): device/<SN>/report
#define MQTT_TOPIC     "device/YOUR_PRINTER_SERIAL/report"

// --- Slack ---
// Incoming Webhook URL (issued under Incoming Webhooks in your Slack App)
#define SLACK_WEBHOOK  "https://hooks.slack.com/services/XXXX/XXXX/XXXX"
【機械学習】VAEの公式サンプルをCVAEに改造してCVAEの仕組みを理解する
以前こちらの記事を書きました。
最終的には「たくさんの画像を元に、画像を滑らかに補間させる方法」を目指していて、その過程でVAEとCVAEという手法を知りました。今回はCVAEの理解を進めるのが目的です。CVAEはConditional Variational Autoencoderの略です。
VAEの公式サンプルがこちらです。いくつか編集することでCVAE対応することができます。
まずVAEの公式サンプルを出力した画像はこちらです。10回学習が回った後に出力された画像です。

こちらは公式サンプルをCVAE化して出力された画像です。1行ずつ0~9までの数字が並んでいます。後述するのですが、「ラベル」という概念により「MNISTのどの数字か」を指定して出力することができるようになります。

※ 本文中の画像は上記サンプルおよびCVAE改造版から出力した画像です。つまり、MNIST データセットで学習したVAE,CVAEの出力画像となります。
コードを編集する
※ 本文中のコードは PyTorch公式のサンプル(ライセンス: BSD-3-Clause)からの引用で、日本語のコメントは自分が入れています。
こちらのリポジトリに自分がコメントを書いたソースの全文が含まれています。
https://github.com/takumifukasawa/vae-cvae-practice:url
CVAEクラス
VAEクラスを編集し、CVAE対応をします。
CVAEは一言でまとめると「ヒントを渡すことができるVAE」というイメージになります。このヒントはラベルと呼ばれます。
特に大きな変更は「情報を入れる箱」のサイズを変えている部分です。 self.fc1 などで +10 をしているのですが、これはラベルを格納するためです。MNISTで0~9の数字を取り扱うので10個分追加します。
class CVAE(nn.Module):
  def __init__(self):
    super(CVAE, self).__init__()

    # mu ... もやの中心(大体の座標)
    # logvar ... もやの広さ(曖昧さ)
    # reparameterize ... もやの中からランダムに1点(z)を選ぶ

    # fc = fully connected (全結合層) ... 数字を変換する箱
    self.fc1 = nn.Linear(784 + 10, 400) # 784個の数字を入れると400個の数字が出てくる
    self.fc21 = nn.Linear(400, 20) # mu: 400個 -> 20個
    self.fc22 = nn.Linear(400, 20) # logvar: 400個 -> 20個
    self.fc3 = nn.Linear(20 + 10, 400) # decode: 20個 -> 400個
    self.fc4 = nn.Linear(400, 784) # 400 -> 784

  def encode(self, x, y):
    h1 = F.relu(self.fc1(torch.cat([x, y], dim=1))) # 784 + 10 = 794 ... つまり、画像とラベルがセットで入る
    return self.fc21(h1), self.fc22(h1)

  # 「点」じゃなくて「もや」にすると潜在空間が滑らかになる
  # そうして生成されるzを連続的に動かすと画像が滑らかに変化する
  # ばらつきと標準偏差を操る = ガウス分布(正規分布)
  def reparameterize(self, mu, logvar):
    std = torch.exp(0.5 * logvar) # ばらつき -> 標準偏差
    eps = torch.randn_like(std) # ランダムなノイズ(サイコロ)
    return mu + eps * std # z = 中心 + ノイズ x ばらつき

  def decode(self, z, y):
    h3 = F.relu(self.fc3(torch.cat([z, y], dim=1))) # 20 + 10 = 30
    return torch.sigmoid(self.fc4(h3)) # 784個の数字(0~1)を返す

  def forward(self, x, y):
    mu, logvar = self.encode(x.view(-1, 784), y) # 画像 -> mu, logvar
    z = self.reparameterize(mu, logvar) # z(今回は20個の数字)が生まれる。zは中間データ(潜在変数)
    return self.decode(z, y), mu, logvar # z -> 画像に復元
「ラベル」を格納する領域が増えたので、decodeやforwardも変更が加わっています。引数に y をとるようになっているのですが、これがラベルを受け取っている部分です。
loss_function
こちらはVAEのサンプルから変更がありません。
# ピクセルごとの復元ズレ(BCE)、潜在の散らかり度(KLD) を足した、1つの減点合計
# Reconstruction + KL divergence losses summed over all elements and batch
def loss_function(recon_x, x, mu, logvar):
  # BCEだけだと復元は正確だがzが散らかる -> 生成や補間がガタガタになる
  BCE = F.binary_cross_entropy(recon_x, x.view(-1, 784), reduction='sum')

  # KLDだけだとzは綺麗だが復元できない(ぼやける)
  # see Appendix B from VAE paper:
  # Kingma and Welling. Auto-Encoding Variational Bayes. ICLR, 2014
  # https://arxiv.org/abs/1312.6114
  # 0.5 * sum(1 + log(sigma ^ 2) - mu ^ 2 - sigma ^ 2)
  # これは実質的にガウス分布の間のKL divergence の式
  # 原点を中心として標準的なばらつきが理想 => 標準正規分布 N(0,1) に寄せる
  KLD = -0.5 * torch.sum(1 + logvar - mu.pow(2) - logvar.exp())

  return BCE + KLD # KLDがVAE独自の方法
train関数
主な変更点は
- enumerate関数の結果で label を受け取るようにしている
- VAEの公式サンプル時点では label を受け取っていないため
- ラベルの one_hot 化
- modelにラベルを渡す
という3点です。
one_hotではラベルを数字の配列に変換します。例えばラベルが7の場合、 [0,0,0,0,0,0,0,1,0,0] という配列になります。ビットの0,1のような考え方ですが、要素の型は数字です。
def train(epoch):
  model.train() # 訓練モード
  train_loss = 0
  for batch_idx, (data, label) in enumerate(train_loader): # label...0~9の整数
    data = data.to(device)
    y = F.one_hot(label, num_classes=10).float().to(device)
    # バッチが128枚の場合
    # data = 画像128枚 -> [128(バッチサイズ), 1(チャンネル数:MNISTが白黒なので1), 28(MNISTの画像サイズ:高さ), 28(MNISTの画像サイズ:幅)]
    # label = 各画像の正解 -> [128]
    # y = one-hotにした配列 -> [128, 10] ex) 7なら[0,0,0,0,0,0,0,1,0,0]

    optimizer.zero_grad()
    recon_batch, mu, logvar = model(data, y) # CVAEの計算をする
    loss = loss_function(recon_batch, data, mu, logvar) # 間違い度合いを計算
    loss.backward() # 直す方向を計算
    train_loss += loss.item() # ログ表示用: loss値を加算し、あとで平均を出す
    optimizer.step() # 重みを直す
    if batch_idx % args.log_interval == 0:
      print(
        'Train Epoch: {} [{}/{} ({:.0f}%)]\tLoss: {:.6f}'.format(
          epoch,
          batch_idx * len(data),
          len(train_loader.dataset),
          100. * batch_idx / len(train_loader),
          loss.item() / len(data)
        )
      )
  print(
    '====> Epoch: {} Average loss: {:.4f}'.format(
      epoch,
      train_loss / len(train_loader.dataset)
    )
  )
test関数
こちらもtrain関数同様の変更が入っています。
def test(epoch):
  model.eval() # 評価モード
  test_loss = 0
  with torch.no_grad():
    for i, (data, label) in enumerate(test_loader):
      data = data.to(device)
      y = F.one_hot(label, num_classes=10).float().to(device)
      recon_batch, mu, logvar = model(data, y)
      test_loss += loss_function(recon_batch, data, mu, logvar).item()
      if i == 0:
        n = min(data.size(0), 8)
        comparison = torch.cat([data[:n], recon_batch.view(args.batch_size, 1, 28, 28)[:n]])
        save_image(comparison.cpu(), 'results/cvae_reconstruction_' + str(epoch) + '.png', nrow=n)

  test_loss /= len(test_loader.dataset)
  print('===> Test set loss: {:.4f}'.format(test_loss))
main関数
100個分の数字を画像に書き出します。1行ずつ0~9が並ぶようになります。
if __name__ == "__main__":
  for epoch in range(1, args.epochs + 1):
    train(epoch) # 学習
    test(epoch) # 検証
    with torch.no_grad():
      # ラベルを作る: 各数字を10枚ずつ = 100枚
      labels = torch.arange(10).repeat_interleave(10) # [0,0,...,1,1,...,9,9]
      y = F.one_hot(labels, 10).float().to(device) # [100, 10]
      z = torch.randn(100, 20).to(device) # ランダムなzを100個
      out = model.decode(z, y).cpu() # zとラベルyを渡す
      save_image(
        out.view(100, 1, 28, 28), # 784個 -> 28x28のグリッドに戻す
        'results/cvae_sample_' + str(epoch) + '.png',
        nrow=10
      )
最後に
実際に手を動かしてみると意外にも大きな変更点は少なく、CVAEがVAEの派生であることがわかりました。ラベルというヒントがある分「こういうものが欲しい」という目的があるときにVAEより適している?ということなのかなと思いました。
【機械学習】VAEの仕組みを公式サンプルから理解する
最近、機械学習の勉強を始めました。pythonも初学者です。
「たくさんの画像を元に、画像を滑らかに補間させる方法」を目指していて、geminiに壁打ちをしていたところVAEやCVAEが良さそうというところまで行きつきました。
VAE = Variational Autoencoder、 CVAE = Conditional Variational Autoencoder のことです。
ただ、機械学習は完全に初学のため基礎理論や種類も何もわかっていない状態です。いろいろな資料やブログ、解説記事などを見たのですが、初見の用語が多かったりで今の知識だとどれもレベルが高く感じられました。
そこで、まずはVAEのサンプルを写経しながらフローを追って確認し、どういう流れで学習が進んでいくのかを確認してみることにしました。
結果的にこの方法は良い学習となりました。「なぜこうなのか」は未だつかめていないところは多いものの、「どうしてそうなるのか」はなんとなく掴むことができたと思います。
VAEのサンプルはこちらです。
10回学習が回った後に出力された画像です。上段が元データ、下が学習後に出力されたデータです。
※ 本文中の画像は上記サンプルから出力した画像です。つまり、MNIST データセットで学習したVAEの出力画像となります。
コードを追う
※ 本文中のコードは PyTorch公式のサンプル(ライセンス: BSD-3-Clause)からの引用で、日本語のコメントは自分が入れています。
こちらのリポジトリに自分がコメントを書いたソースの全文が含まれています。
https://github.com/takumifukasawa/vae-cvae-practice:url
main関数
main関数では指定したループ分、学習と検証を繰り返します。学習ではモデルの更新を、検証では元データと出力の差分確認を行っています。
if __name__ == "__main__":
  for epoch in range(1, args.epochs + 1):
    train(epoch) # 学習
    test(epoch) # 検証
train関数
def train(epoch):
  model.train() # 訓練モード
  train_loss = 0
  for batch_idx, (data, _) in enumerate(train_loader):
    data = data.to(device)
    optimizer.zero_grad()
    recon_batch, mu, logvar = model(data) # VAEの計算をする
    loss = loss_function(recon_batch, data, mu, logvar) # 間違い度合いを計算
    loss.backward() # 直す方向を計算
    train_loss += loss.item() # ログ表示用: loss値を加算し、あとで平均を出す
    optimizer.step() # 重みを直す
    if batch_idx % args.log_interval == 0:
      print(
        'Train Epoch: {} [{}/{} ({:.0f}%)]\tLoss: {:.6f}'.format(
          epoch,
          batch_idx * len(data),
          len(train_loader.dataset),
          100. * batch_idx / len(train_loader),
          loss.item() / len(data)
        )
      )
  print(
    '====> Epoch: {} Average loss: {:.4f}'.format(
      epoch,
      train_loss / len(train_loader.dataset)
    )
  )
model()でVAEの計算が行われ、loss_function() でデータのずれを計算しています。
これがmain関数のループの中で処理され、学習が進んでいく構図になります。
VAE
modelはVAEクラスから生成されています。
class VAE(nn.Module):
  def __init__(self):
    super(VAE, self).__init__()

    # mu ... もやの中心(大体の座標)
    # logvar ... もやの広さ(曖昧さ)
    # reparameterize ... もやの中からランダムに1点(z)を選ぶ

    # fc = fully connected (全結合層) ... 数字を変換する箱
    self.fc1 = nn.Linear(784, 400) # 784個の数字を入れると400個の数字が出てくる
    self.fc21 = nn.Linear(400, 20) # mu: 400個 -> 20個
    self.fc22 = nn.Linear(400, 20) # logvar: 400個 -> 20個
    self.fc3 = nn.Linear(20, 400) # decode: 20個 -> 400個
    self.fc4 = nn.Linear(400, 784) # 400 -> 784

  def encode(self, x):
    h1 = F.relu(self.fc1(x))
    return self.fc21(h1), self.fc22(h1)

  # 「点」じゃなくて「もや」にすると潜在空間が滑らかになる
  # そうして生成されるzを連続的に動かすと画像が滑らかに変化する
  # ばらつきと標準偏差を操る = ガウス分布(正規分布)
  def reparameterize(self, mu, logvar):
    std = torch.exp(0.5 * logvar) # ばらつき -> 標準偏差
    eps = torch.randn_like(std) # ランダムなノイズ(サイコロ)
    return mu + eps * std # z = 中心 + ノイズ x ばらつき

  def decode(self, z):
    h3 = F.relu(self.fc3(z))
    return torch.sigmoid(self.fc4(h3)) # 784個の数字(0~1)を返す

  def forward(self, x):
    mu, logvar = self.encode(x.view(-1, 784)) # 画像 -> mu, logvar
    z = self.reparameterize(mu, logvar) # z(今回は20個の数字)が生まれる。zは中間データ(潜在変数)
    return self.decode(z), mu, logvar # z -> 画像に復元

model = VAE().to(device)
optimizer = optim.Adam(model.parameters(), lr=1e-3)
encode関数が「中心とばらつき」を算出し、reparameterize関数でそれを使ってzをサンプリングしています。
つまり実質的に正規分布のちらばりを計算していることになります。
そのため「とある一点の誤差の比較」ではなく、「zを分布として表してサンプリングする」というアプローチのようです。
loss_function
reparameterize関数ではばらつきの計算を行なっていましたが、その「ばらつきが標準正規分布からどれぐらいずれているか」を測るのが loss_function の中身で、具体的にはKLD変数となります。
# ピクセルごとの復元ズレ(BCE)、潜在の散らかり度(KLD) を足した、1つの減点合計
# Reconstruction + KL divergence losses summed over all elements and batch
def loss_function(recon_x, x, mu, logvar):
  # BCEだけだと復元は正確だがzが散らかる -> 生成や補間がガタガタになる
  BCE = F.binary_cross_entropy(recon_x, x.view(-1, 784), reduction='sum')

  # KLDだけだとzは綺麗だが復元できない(ぼやける)
  # see Appendix B from VAE paper:
  # Kingma and Welling. Auto-Encoding Variational Bayes. ICLR, 2014
  # https://arxiv.org/abs/1312.6114
  # 0.5 * sum(1 + log(sigma ^ 2) - mu ^ 2 - sigma ^ 2)
  # これは実質的にガウス分布の間のKL divergence の式
  # 原点を中心として標準的なばらつきが理想 => 標準正規分布 N(0,1) に寄せる
  KLD = -0.5 * torch.sum(1 + logvar - mu.pow(2) - logvar.exp())

  return BCE + KLD # KLDがVAE独自の方法
binary cross entropy は分類問題の損失関数で、モデルが出力する確率と実際のラベルのずれを測る関数とのことです。
(ラベル = 一つ一つのデータに対する正解を示す情報)
(分類問題 = データが属するラベルなどを予測する機械学習の問題のこと?)
正確な理解はできていないのですが、「データ元と出力のずれ」を測定する関数、というイメージでいます。
test関数
modelでばらつきを計算、loss_functionで誤差を累積し、最終的に平均をとって「どれぐらい誤差があったか」を確認しています。
def test(epoch):
  model.eval() # 評価モード
  test_loss = 0
  with torch.no_grad():
    for i, (data, _) in enumerate(test_loader):
      data = data.to(device)
      recon_batch, mu, logvar = model(data)
      test_loss += loss_function(recon_batch, data, mu, logvar).item()
      if i == 0:
        n = min(data.size(0), 8)
        comparison = torch.cat([data[:n], recon_batch.view(args.batch_size, 1, 28, 28)[:n]])
        save_image(comparison.cpu(), 'results/reconstruction_' + str(epoch) + '.png', nrow=n)

  test_loss /= len(test_loader.dataset)
  print('===> Test set loss: {:.4f}'.format(test_loss))
フローの大枠
そもそもVAEの前身に当たるAEでは「潜在変数(z)を1点で表し、復元するときの誤差」で学習がなされます。これを改良したのがVAEです。
AEとの違いは以下のように整理できます。
エンコーダは画像を潜在変数(z)に圧縮し、デコーダはその潜在変数から画像に復元する役割となります。
普通のAE: 画像 -> エンコーダ -> z(1点) -> デコーダ -> 画像
VAE: 画像 -> エンコーダ -> mu,logvar(分布) -> サンプリング(ランダムに散らす) -> z -> デコーダ -> 画像
また、VAEの特徴をまとめると以下のようになります。
- エンコーダがmu,logvarを計算。AEのような1点ではなく「中心 + ばらつき」を返す(「こういう範囲のどこか」という正規分布として表す)
- reparameterize: その範囲からzをサイコロで決める(mu(中心)にランダムなブレを足して zを作る)。「毎回ちょっと違うzになる」のが肝の一つ
- 損失に KLD を用いる。zの分布を原点周りの綺麗な形に保つ、という制約。普通のAEはBCE(復元誤差)だけでKLDが無い。
補間に関しては、
1,2により、zを点じゃなくて「ブレのある範囲」にすることにより、zが近い画像同士は似た画像になる(潜在空間が滑らかになっている)
3により、KLDでzを原点周りに集約させる -> 空間に穴ができず、どこをサンプリングしても破綻の少ない画像が出る。
この結果、ランダムなzから生成できる/補間が滑らかになる。
ということです。
試しに補間を確認してみた画像です。例えば一番上段は 3 <-> 8 を線形補間的に表しています。

最後に
機械学習でも乱数を使うというのが発見でした。ダイスを振って乱数を加えたりして「毎回ちょっと違う画像出力になる」というのが、どことなくレイトレーシングやAmbientOcclusionのノイズ計算を思い出して興味深かったです。
WSL2をWSL1に変更する
きっかけ
WSL2でviteを使って開発していたのですが、しばらく立ち上げているとHMRが応答せずWSLを落とさなければならない、ということが頻発していました。
開発環境としては、
- ファイルそのものはWindowsOS側で管理
- エディターはVSCodeやRiderなどWindowsOS側のアプリケーション
- しかし、vite自体はWSLで動作させたい
という状態です。つまり、WindowsOS側とWSLでファイルを相互に見合っていました。
改めて調べてみると「ファイルを相互に見合う状態」はWSL1を使った方がよいというユースケースに当てはまりそうなため、WSL1に戻すことを試してみました。
WSL2からWSL1にバージョンを落とす
まずWSLのバージョンを確認します。
$ wsl -l -v

NAME            STATE           VERSION
* Ubuntu-22.04    Running         2
WSL2になっていますね。
WSLのデフォルトバージョンと、変更したいディストリビューションをそれぞれ WSL1 にします。
$ wsl --set-default-version 1
$ wsl --set-version [ubuntu_name] 1
=> 自分の環境では $ wsl --set-version Ubuntu-22.04 1
再起動します。
$ wsl
本来はこの時点で無事WSL1になった状態で立ち上がるようですが、自分の場合は以下のエラーが出てうまくいきませんでした。
<3>WSL (11) ERROR: CreateProcessEntryCommon:577: execvpe /home/linuxbrew/.linuxbrew/bin/zsh failed 14
どうやらzshが影響していそうです。
ということでWSL2に戻してから shell を bash にし、改めてWSL1に変更します。
...

先ほどのWSL1にした手順と同様にバージョンを2にする

...

$ sudo chsh $USER -s $(which bash)

...

先ほどのWSL1に変更する手順をもう一度実行

...

$ wsl
これで無事起動しました。
ただ、WSL1になった状態でshellをzshに変更するとまた同様のエラーが出たので、bashのままにしています。
WindowsにおけるWebフロントエンド開発は「ファイルをWindowsOSとWSLで相互に見合う」状態になることは珍しくないと思うので、WSL2においてファイルシステム管理の問題が残り続ける限りはWSL1のままにしておくのが安全そうです。
【WebGL2】threejs で Deferred Shading
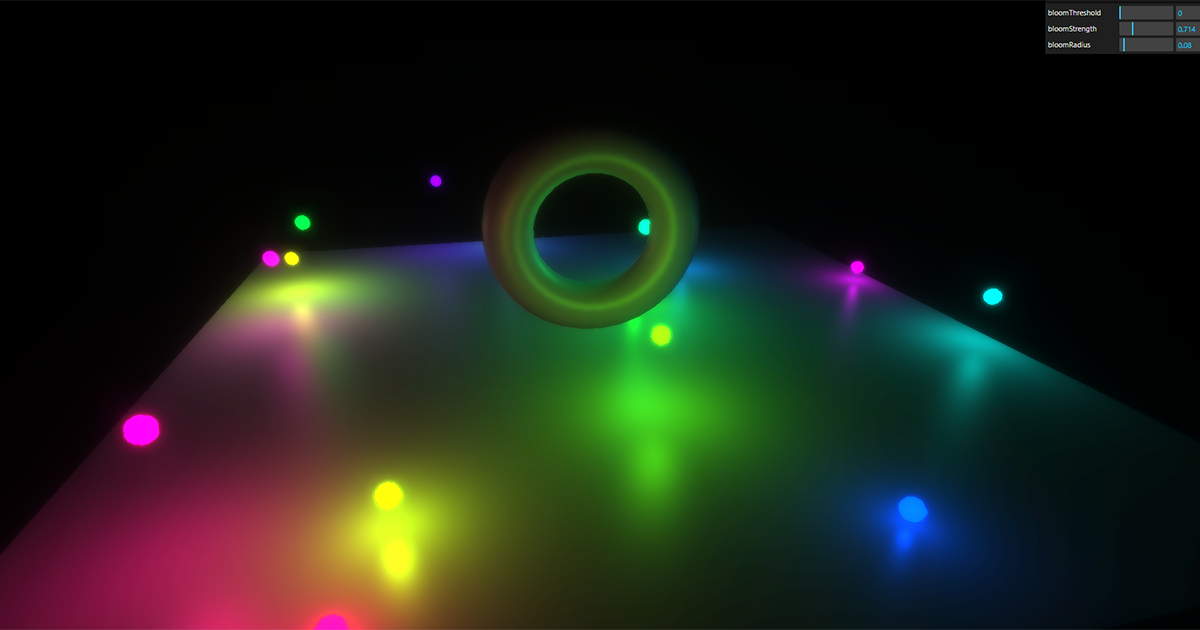
リポジトリとデモはこちらになります。
https://takumifukasawa.github.io/threejs-deferred-shading/base.html
https://takumifukasawa.github.io/threejs-deferred-shading/point-light.html
https://takumifukasawa.github.io/threejs-deferred-shading/post-process.html
WebGL2がiOS15から有効になり、WebGL1までは拡張機能となっていた MRT(Multiple Render Target)が標準機能になりました。
MRTを使って実現しやすくなることの中に、DeferredShadingが含まれます。今回はthreejsでDeferredShadingを実現する方法を探りました。
threejsを使うことにしたのは、仕事を踏まえてどれぐらい使えそうかも確認したい展望もあったためです。
Deferred Shading
解説している記事がたくさんあるので、ここでは簡単に説明を記載します。こちらの記事がわかりやすいです。
【Unity】Deferred Shadingでライトを贅沢に使いたい!基本的な概念の説明とメリデメを考察 - LIGHT11
ディファードレンダリングだったり、遅延シェーディングと呼ばれたりもします。ここでは、 Deferred Shading と呼ぶことにします。
古典的なレンダリング方法である Forward Shading ではポリゴンを描画する際にライティングなどを加味した色も計算します。つまり、ポリゴン(メッシュ)が描画されるごとに色を決定していく方法です。 一般的にはこちらが使われていますね。
Deferred Shadingでは、ポリゴンを描画する際に色を決定する方法はとらず、深度や法線など色を決定するのに必要な情報群をバッファ群(G-Buffer)に一度格納し、そのバッファを元にライティングなどの色を決定させていく方法です。
G-BufferはGeometry Bufferと呼ばれます。メッシュのジオメトリ情報(法線やカラーなど)を格納するバッファです。後述しますが、G-Bufferに入れる情報は自分で定義することができるので、ジオメトリ情報に限らずデータを入れていくことが可能です。
メリット
Forward Shadingと比べて、多数のライトを置けること、ポストプロセスでG-Bufferの情報をあつかうことができる点です。SSAOやSSRは導入しやすくなるでしょう。
デメリット
半透明描画はG-Bufferの色の計算のあとに行う必要があるので結局ForwardShadingを使うことになり複雑になる点です。
また、ポストプロセス的にピクセル数分ライティングの計算が走るので計算負荷がかかりすいこと、マテリアルの種類が多くなればなるほシェーダー内での分岐が必要になる・それがピクセル数分の計算になるためシェーダーが重くなりやすいことも欠点の内かなと思います。
threejsでMRT
MultipleRenderTarget というクラスが用意されているのでそちらを使ってみます。
three.js webgl - Multiple Render Targets
ただ、中身を見るとRGBA32bit以外のフォーマットは選ぶことができないようになっていたので必要なG-Bufferの情報に合わせて自分で似たような仕組みを作ってあげてもよいと思います。
G-Bufferに入れる情報
G-Bufferの中身は自分で定義することができます。つまり、アプリケーションごとに異なるということですね。
今回は2枚用意します。格納する情報は以下です。
index 0: RGBA32bit(RGB: メッシュの色、A: マテリアルのインデックス)
index 1: RGBA32bit(RGB: ワールド座標系の法線情報を0-1に変換したもの、A: 1
深度情報は MultipleRenderTarget.depthTexture でアクセスできるのでそちらを使います。
法線情報をワールド座標系にしているのはワールド座標基準でライティングを計算することに決めたためです。正規化された法線はxyzが-1~1に収まるので、0~1に直しておく点がポイントです。
MultipleRenderTargetsからMRTのテクスチャを渡すためには、textureが配列になっているのでuniformと紐づけて渡します。
    const gBufferPaths = [
        {
            name: "diffuse",
        },
        {
            name: "normal"
        },
    ]

    // サイズは後で変更
    const renderTarget = new THREE.WebGLMultipleRenderTargets(1, 1, gBufferPaths.length);
    renderTarget.texture.forEach(texture => {
        texture.minFilter = THREE.NearestFilter;
        texture.magFilter = THREE.NearestFilter;
    });
    gBufferPaths.forEach((({ name }, i) => {
        renderTarget.texture[i].name = name;
    }));

    ...

    const postprocessMaterial = new THREE.RawShaderMaterial({
        vertexShader: renderVertexShaderText,
        fragmentShader: renderFragmentShaderText,
        uniforms: {
            uDiffuse: {
                value: renderTarget.texture[0]
            },
            uNormal: {
                value: renderTarget.texture[1]
            },
            uDepth: {
                value: renderTarget.depthTexture,
            },

    ...
MRTに情報を書く
Forward Shadingではピクセルシェーダーで出力するのは「0-1で表現された色」になります。
対してDeferred Shadingではピクセルシェーダーで各バッファに出力する情報群を書きだします。
生WebGLでの実装はwgld.orgの記事が分かりやすいです。
wgld.org | WebGL: MRT(Multiple render targets) |
こちらは実際に今回書いたG-Bufferにデータを格納するピクセルシェーダーです。
本来は色だけを出力しているところが、out修飾子のついているgColorとgNormalの二つに値を渡していることがわかると思います。
precision highp float;
precision highp int;
layout(location = 0) out vec4 gColor;
layout(location = 1) out vec4 gNormal;
in vec3 vNormal;
in vec2 vUv;
uniform float uMaterial;
uniform vec3 uBaseColor;

void main() {
    gColor = vec4(uBaseColor, uMaterial);
    vec3 normal = (normalize(vNormal) + 1.) * .5;
    gNormal = vec4(normal , 1.);
}
shading
ワールド座標
いよいよG-Bufferを元に色を決定していきます。G-Bufferや深度テクスチャを元に、法線・色・深度の情報はすでに揃っています。
しかし、ワールド座標基準でのライティングにはまだ足りないものがあります。それは該当ピクセルのワールド座標です。
G-Bufferに格納することも可能ですが、それではG-Bufferのバッファが一枚増えることになるので負荷も上がります。
ここでは、以下のようなシェーダーで深度からワールド座標を復元する方法をとります。
// depth: depth buffer から読みだした値をそのまま渡す
vec3 getWorldPositionFromDepth(vec2 uv, float depth) {
    vec4 ndc = vec4(uv * 2. - 1., depth * 2. - 1., 1.);
    vec4 wp = uInverseViewMatrix * uInverseProjectionMatrix * ndc;
    wp.xyz /= wp.w;
    return wp.xyz;
}
やっていることは以下です。
ライティング計算
必要な情報が揃ったらライティングを計算します。疑似的なコードになりますが、最も単純なのはライトの数分ループを回しライティングを計算する方法です。
vec4 color;

...

for(int i = 0; i < lightNum; i++)
{
    PointLight pointLight = uPointLights[i];
    color += calcPointLight(pointLight, surface, camera); // ポイントライトの数だけライティングの影響を計算をする
}
改善
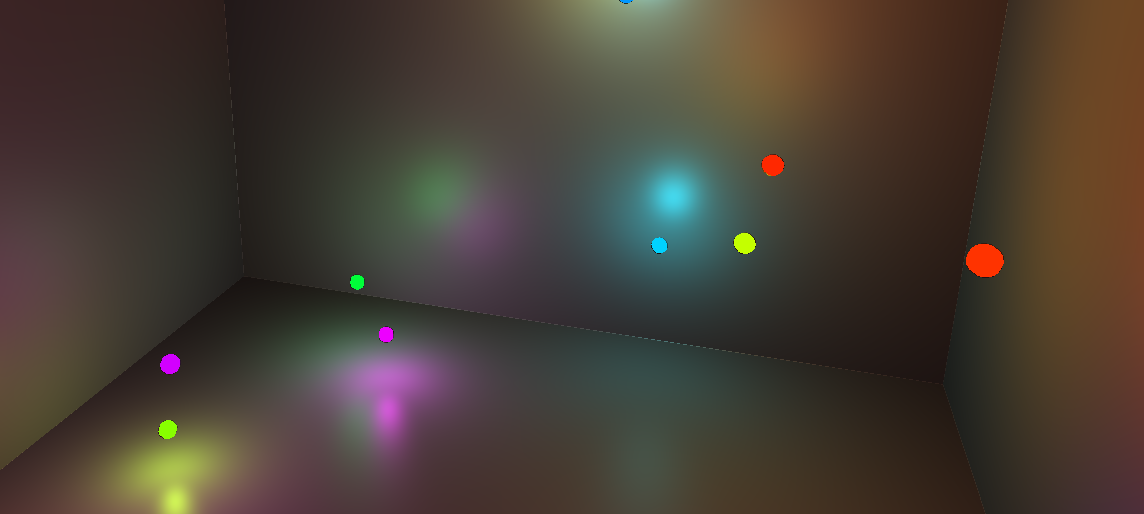
画像のようにアーティファクトが出ています。どういう原因なのかがまだつかめていないのですが、隣接ピクセルが、他のポリゴンのピクセルが存在しないピクセルの場合、1pxだけ白くなってしまっています。
おそらくthreejsのrendererの設定かシェーダーの精度などが原因のように推察しているのですが、まだ未解決です。
参考
three.js webgl - Multiple Render Targets
three.js/WebGLMultipleRenderTargets.js at master · mrdoob/three.js · GitHub
three.js webgl - Depth Texture
G-Buffer の深度値からワールド空間の位置を復元した秋 2016 - Engine Trouble
opengl - GLSL Light (Attenuation, Color and intensity) formula - Game Development Stack Exchange
【Unity】Screen Space Reflection のカスタムポストプロセスを forward rendring で実装
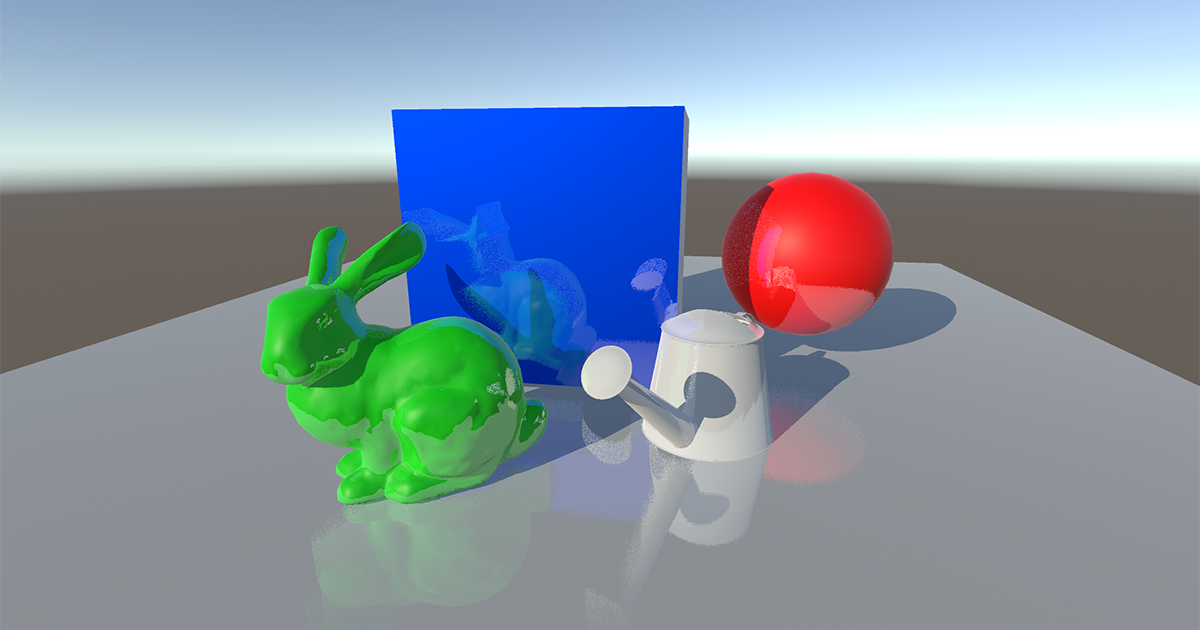
ポストプロセス的に反射表現を実現する方法である Screen Space Reflection を実装してみました。
サンプルリポジトリはこちらになります。
環境
Unity 2021.3.23f1 built-in pipeline
forward rendering
前段
リアルタイムレンダリングのラスタライズ法において反射は、特に負荷のかかりやすく工夫のいる表現の代表例だと思います。視点に依存したり、周囲の環境による部分が大きいですからね。「周りの写り込み」が入ることによって圧倒的に情報量と説得力が増しますが、どこまで反射を表現するかによってとる方法が大きく変わります。
「周囲の環境を踏まえた反射色の決定」の実現でまず思いつくのは、環境マップです。なんとなく反射の情報量を増やしたい場合は環境マップで事足りるケースが多いと思います。しかし、環境マップに「動くもの」も含めるのは骨が折れます。端末のスペックが十分であれば環境マップをリアルタイムに生成し続けることで実現できます。しかし、特にモバイルではスペックが足りず厳しいでしょう。
また、解像度感も問題になります。綺麗な環境マップを生成するには解像度を高くすればよいのですが、環境マップ用に周囲の6面をテクスチャに焼き、環境マップを生成し...という過程を経るのでやはりランタイムでは相当な負荷が予想されます。負荷を考えると解像度は低くするべきですが、鏡面反射に近いようなマテリアルでは解像度不足感が否めない可能性があります。
Screen Space Reflection も高負荷な処理の一つですが、ポストプロセス的なアプローチで「動くもの」を反射に加えることができます。
実装
下準備
シーンの深度情報と法線方向の情報、色情報が必要です。deferred rendring は G-Buffer から法線などを参照することが可能ですが、builtin-pipeline の forward rendering の場合は一工夫が必要です。
具体的にはdepthTextureModeを操作し、シェーダー内で深度と法線情報を取得できるようにします。
_camera.depthTextureMode |= DepthTextureMode.DepthNormals;
https://docs.unity3d.com/Manual/SL-CameraDepthTexture.html
これを設定すると、テクスチャに深度と法線が一まとめに格納されます。frame debugger に表示されている UpdateDepthNormalsTexture が深度・法線をテクスチャに書き込んでいくパスです。
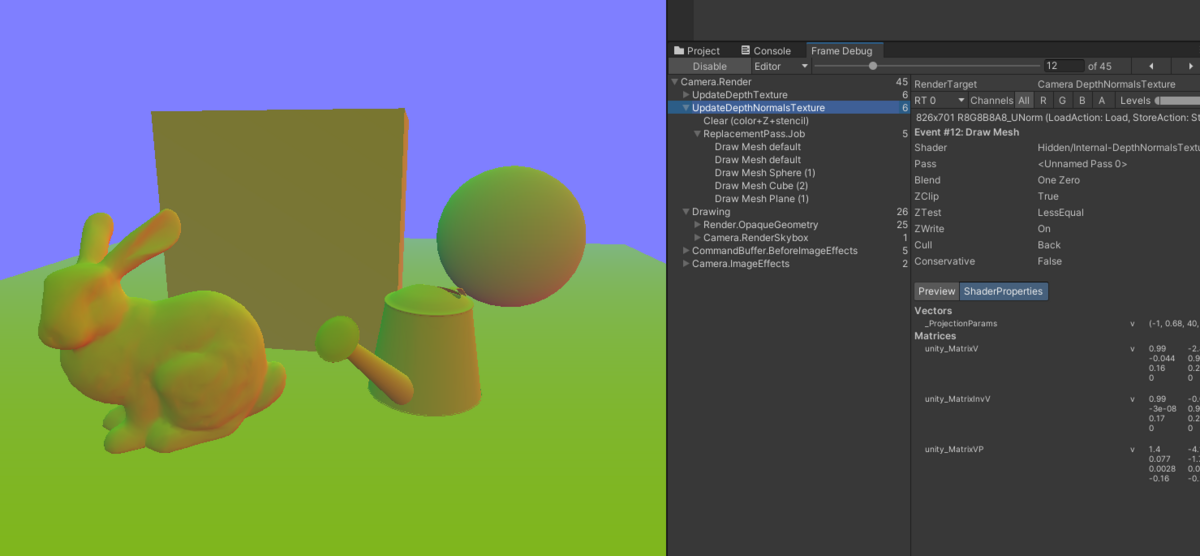
DepthNormalなテクスチャをシェーダー側からデコードして深度と法線を取り出すコードは下記です。深度は線形化されたもので、法線はビュー座標系になっています。
プロジェクトでは、デコードする関数の一部をUnityCG.cgincから参照してきています。UnityCG.cgincを参照していればこの関数の記述は必要ありません。
    ...

    TEXTURE2D_SAMPLER2D(_CameraDepthNormalsTexture, sampler_CameraDepthNormalsTexture);

    ...

    // ------------------------------------------------------------------------------------------------
    // ref: UnityCG.cginc
    // ------------------------------------------------------------------------------------------------

    float DecodeFloatRG(float2 enc)
    {
        float2 kDecodeDot = float2(1.0, 1 / 255.0);
        return dot(enc, kDecodeDot);
    }

    void DecodeDepthNormal(float4 enc, out float depth, out float3 normal)
    {
        depth = DecodeFloatRG(enc.zw);
        normal = DecodeViewNormalStereo(enc);
    }

    ...

        float depth = 0;
        float3 viewNormal = float3(0, 0, 0);
        float4 cdn = SAMPLE_TEXTURE2D(_CameraDepthNormalsTexture, sampler_CameraDepthNormalsTexture, i.texcoord);
        DecodeDepthNormal(cdn, depth, viewNormal);
レイを飛ばす
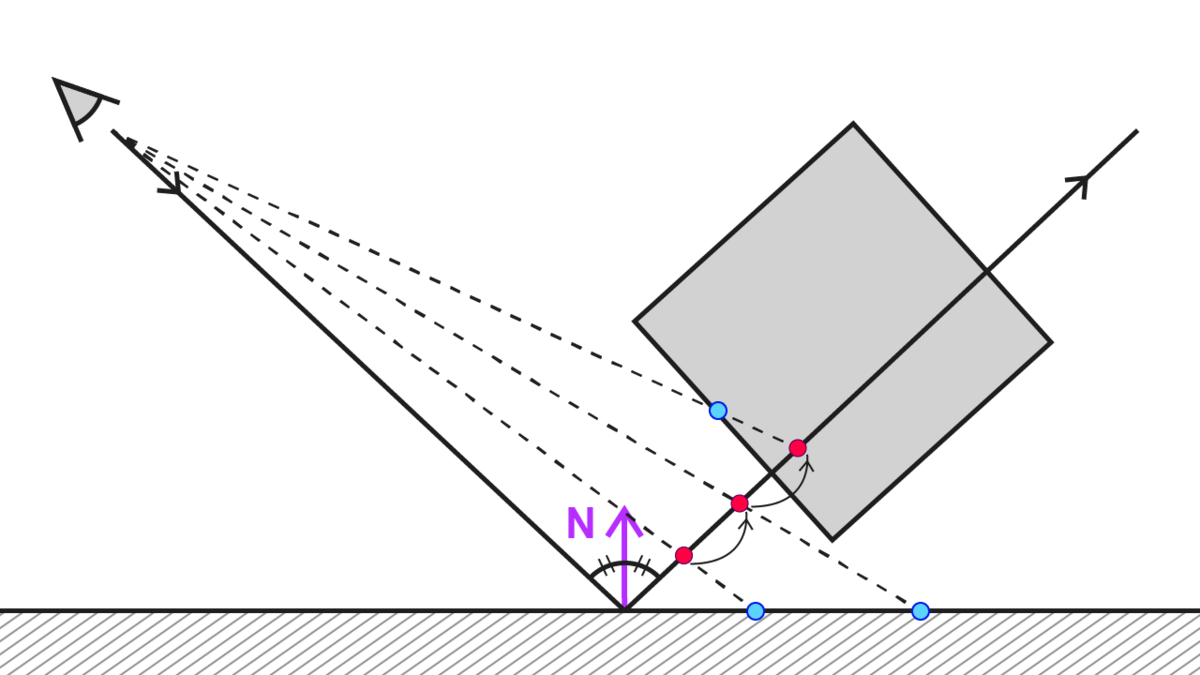
まずピクセルごとに、視点からジオメトリの座標までのベクトルを算出し、法線方向に反射したベクトルを求めます。
「ジオメトリの座標」はワールド座標でも、ビュー座標でもクリッピング座標でも問題ありません。任意の座標系で実装します。サンプルでは、後述するフェードの実装のしやすさなどの関係でビュー座標系を基本とします。
次に、反射したベクトル方向に、等距離ずつサンプル点を移動させていきます。レイマーチングやレイトレに馴染みのある方だと「反射方向にレイを進めていく」という表現が分かりやすいかなと思います。
レイを進めていきながら、「カメラから描画されたジオメトリまでの距離(青の点)」と「レイの位置までの距離(赤の点)」を比較します。
青の点が赤の点よりもカメラに近い場合、「反射してぶつかった場所」とみなします。
そして、反射してぶつかった場所の色をサンプルし、加算などブレンドをします。図ですと、青い点の中の一番上のものを反射で写りこむ色として捉えます。
厚みを考慮する
見た目の精度を高めていく実装です。
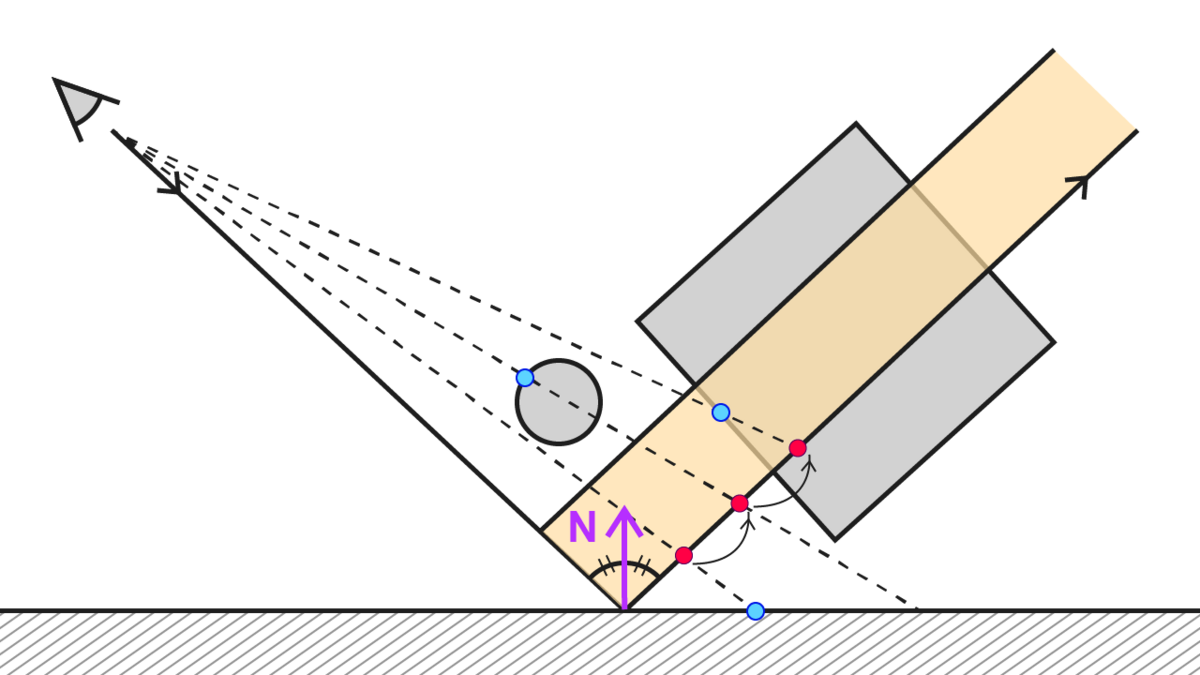
前述のように「カメラから描画されたジオメトリまでの距離」と「レイの位置までの距離」を比較し前者の方が近ければ反射とみなすのですが、大きな問題が一つあります。
それは、この2つの距離が離れすぎているケースです。
近いかどうかだけを判断している場合、極論ですがカメラからジオメトリまでの距離が10m、カメラからレイの位置までが10000mとしたら、それも反射色をサンプルする対象になってしまいます。そのため、シーンによっては違和感のある反射が生まれます。
なので、レイとジオメトリまでの距離も考慮し、反射でぶつかったとみなす範囲を制限する実装にしてみます。例えば距離が0.1~5mまでの範囲内であれば反射してぶつかったとみなす、という具合ですね。
        ...

        for (int j = 0; j < maxIterationNum; j++)
        {
            float stepLength = rayDeltaStep * (j + 1 + jitter * _ReflectionRayJitterSize) + _RayNearestDistance;
            currentRayInView = rayViewOrigin + rayViewDir * stepLength;
            float sampledRawDepth = SampleRawDepthByViewPosition(currentRayInView, float3(0, 0, 0));
            float3 sampledViewPosition = ReconstructViewPositionFromDepth(i.texcoord, sampledRawDepth);

            float4 currentRayInClip = mul(_ProjectionMatrix, float4(currentRayInView, 1.));
            currentRayInClip.xyz /= currentRayInClip.w;

            // クリッピング座標の外に出たら棄却
            // zは一旦考慮しない
            if(abs(currentRayInClip.x) > 1. || abs(currentRayInClip.y) > 1.)
            {
                break;
            }

            float dist = sampledViewPosition.z - currentRayInView.z;
            if (_RayDepthBias < dist && dist < _ReflectionRayThickness)
            {
                isHit = true;
                break;
            }
        }

        ...
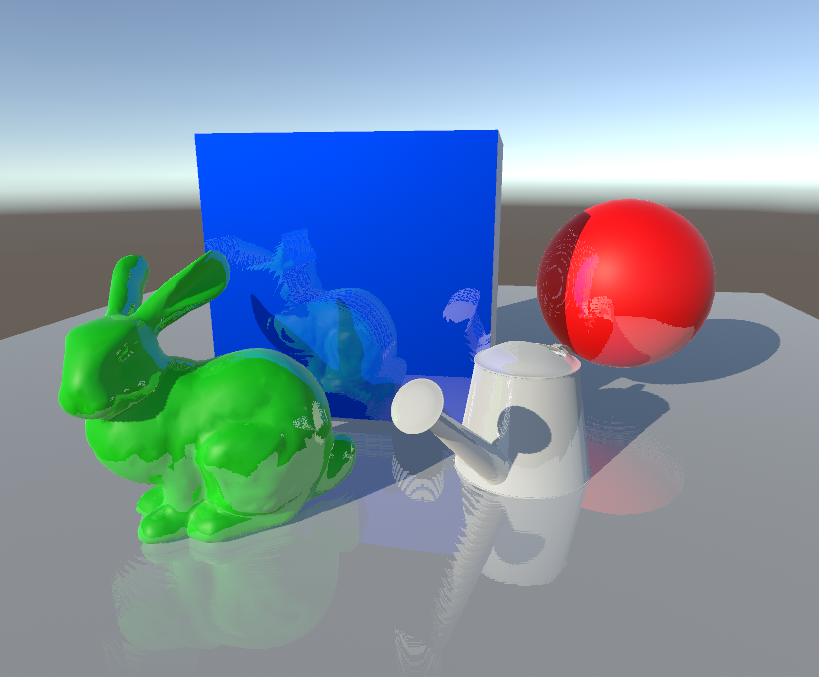
thickness off
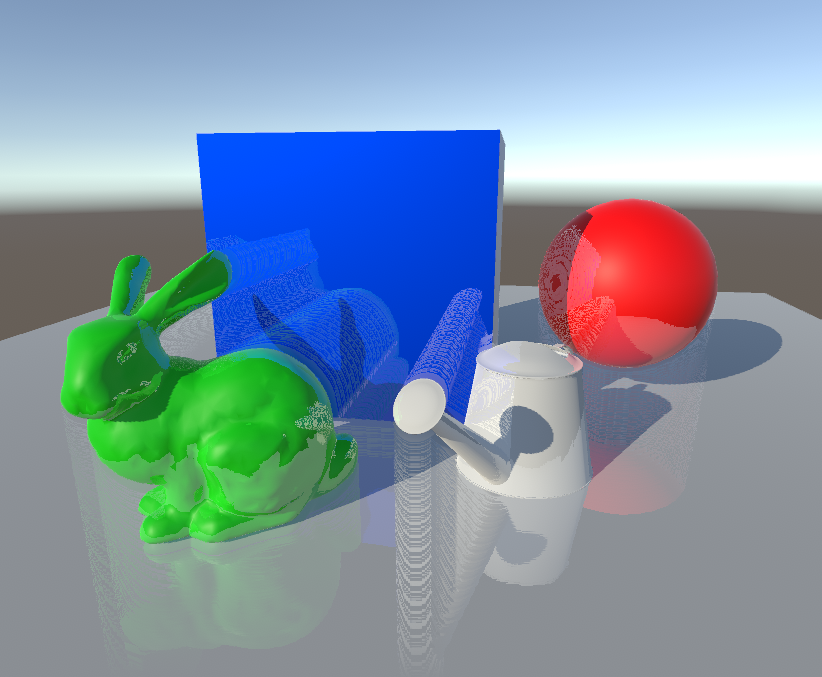
thickness on
二分探索(バイナリサーチ)
いわゆるバイナリサーチの考え方の応用になります。レイを少しずつ進めていく実装では精度は「レイを進める回数」「進む間隔(ステップ)」に大きく依存します。しかし、精度を上げようとすればするほど計算が重くなります。たとえば64回レイを進めながら反射しているかどうかを確認する場合、1280x720の画面だったとしたら 1280x720x64 = 58982400 回分の探索が毎フレームで発生する計算になります。
また、ステップの間隔が広すぎるとマッハバンドのような段々が出来てしまいます。かといって、狭すぎると近い距離までの反射しか考慮できないので、物足りなさがあります。
そこで、バイナリサーチを使って探索回数を最適化していきます。実装としては、等距離で進む部分は変わりませんが、ヒットした場合に反射の色のサンプル位置をより詳細に探っていきます。
「大まかにステップを進め」、「ヒットしたら詳細に探索をしていく」ようなイメージです。
図のような手順を踏みます。
ヒットしたらバイナリサーチを開始。ステップ間隔を半分にして戻る
ヒットしたかどうか確認
ヒットしたらステップ感覚を半分に戻る / ヒットしなかったらステップ間隔を半分にして進む
2,3を任意の数繰り返す
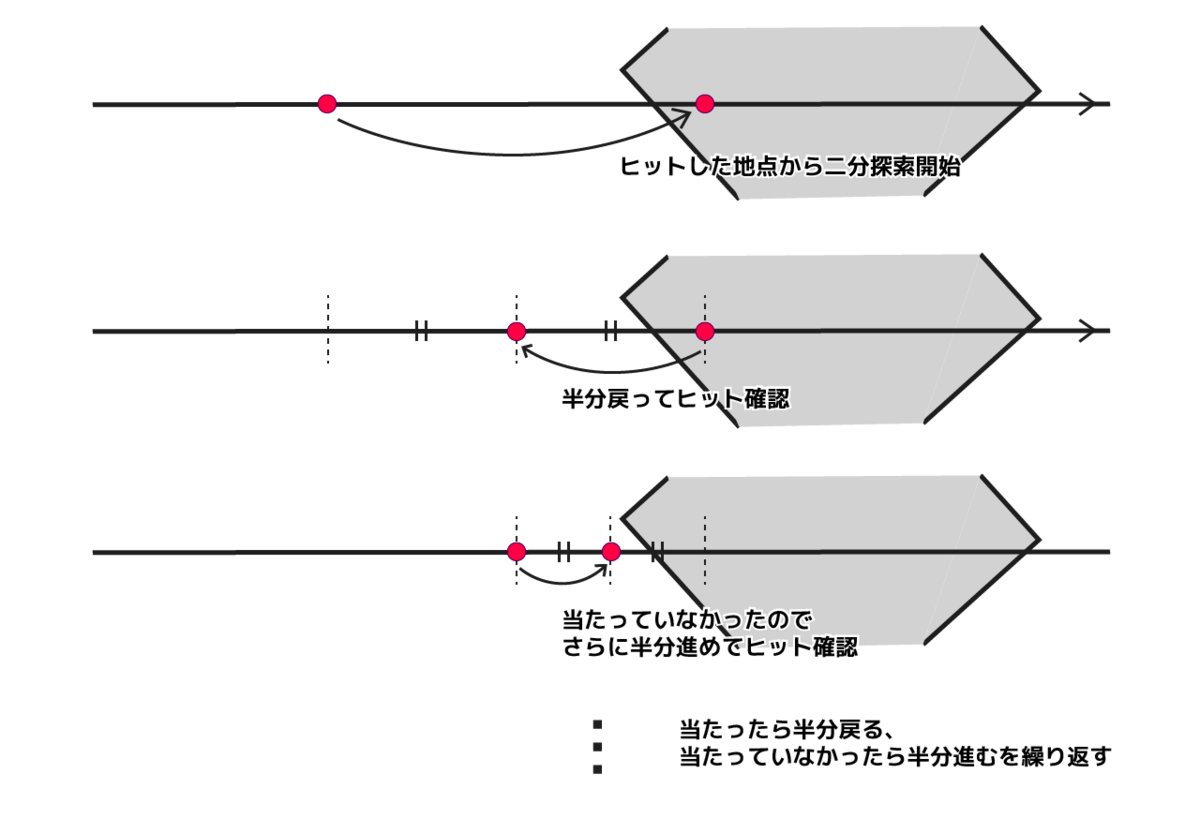
こうすることで、大まかなステップを30回・詳細なステップを8回とすると、レイを進める回数は30+8で38回になります。バイナリサーチを使うことで、レイを進める回数を減らしつつ段々になってしまう間隔を多少狭くすることができます。
        if (isHit)
        {
            // stepを一回分戻す
            currentRayInView -= rayViewDir * rayDeltaStep;

            float rayBinaryStep = rayDeltaStep;
            float stepSign = 1.;
            float3 sampledViewPosition = viewPosition;

            for (int j = 0; j < binarySearchNum; j++)
            {
                // 衝突したら半分戻る。衝突していなかったら半分進む
                // 最初は stepSign が正なので半分進む
                rayBinaryStep *= 0.5 * stepSign;
                currentRayInView += rayViewDir * rayBinaryStep;

                float sampledRawDepth = SampleRawDepthByViewPosition(currentRayInView, float3(0, 0, 0));
                sampledViewPosition = ReconstructViewPositionFromDepth(i.texcoord, sampledRawDepth);

                float dist = sampledViewPosition.z - currentRayInView.z;
                stepSign = _RayDepthBias < dist ? -1 : 1;
            }

            float4 currentRayInClip = mul(_ProjectionMatrix, float4(currentRayInView, 1.));
binary search off
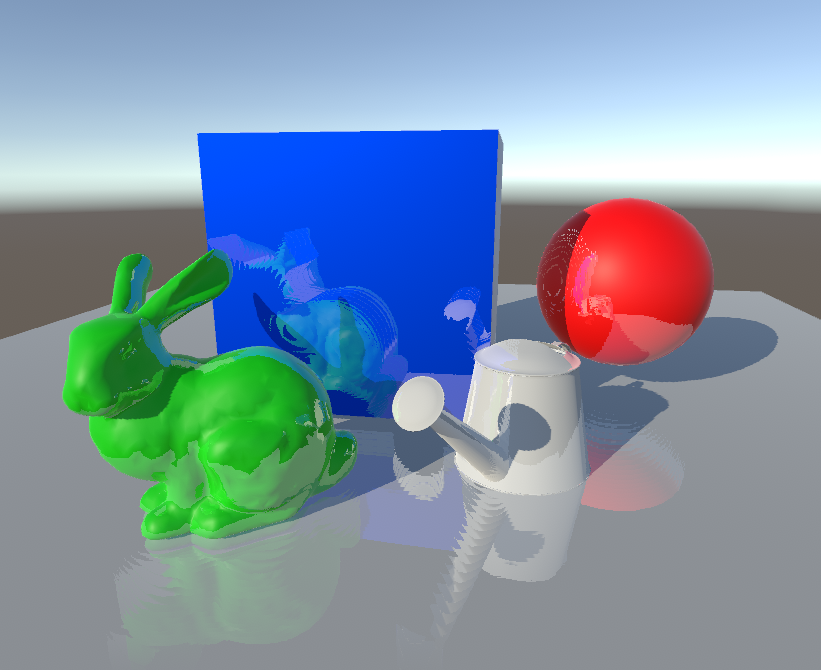
binary search 8 times
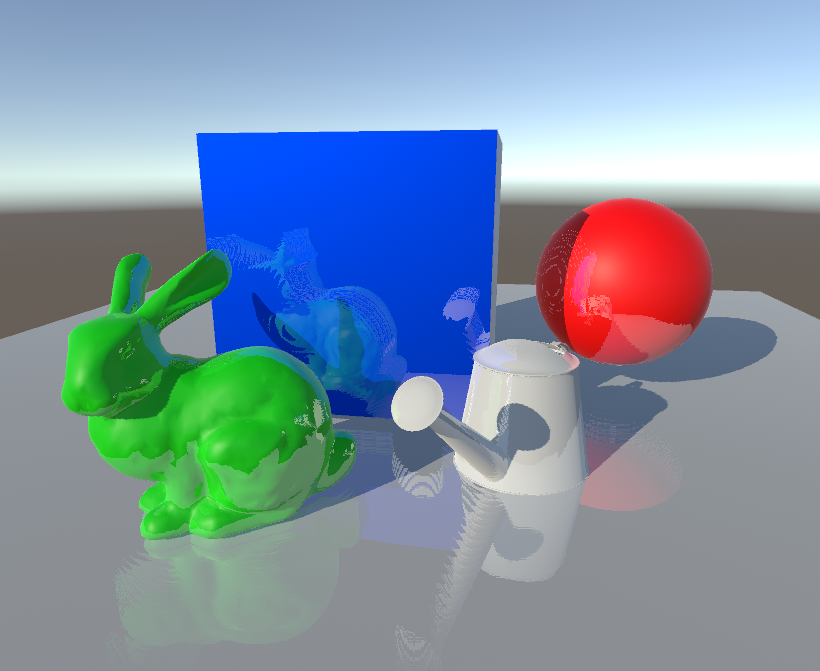
jitter
バイナリサーチを使ってレイを飛ばす回数の最適化をしても、レイを飛ばす間隔に依存してマッハバンドのような段差の軽減は限界があります。そこで、レイを飛ばすときにレイの方向をちょっとずらして散らすことで、精度が低く感じる見た目を軽減させます。
レイトレーシングでは重点サンプリングをするために飛ばすレイを散らすことでノイズ軽減をする方法がありますがそのイメージが近いです。
また、ちょっとしたブラー的な効果を得ることができます。
欠点は、時間依存でランダムにノイズを足そうとするとカメラが止まっているときでもノイズが走り続けているような見た目になることです。カメラが止まっているときはノイズの散らし方を変えないようにしたり、後述するような平均化を行うと軽減されるはずです。
    float noise(float2 seed)
    {
        return frac(sin(dot(seed, float2(12.9898, 78.233))) * 43758.5453);
    }

    ...

        float jitter = noise(i.texcoord + _Time.x) * 2. - 1.;
        float2 jitterOffset = float2(jitter * _ReflectionRayJitterSizeX, jitter * _ReflectionRayJitterSizeY);

        for (int j = 0; j < maxIterationNum; j++)
        {
            float stepLength = rayDeltaStep * (j + 1) + _RayNearestDistance;
            currentRayInView = rayViewOrigin + float3(jitterOffset, 0.) + rayViewDir * stepLength;
    ...
jitter off
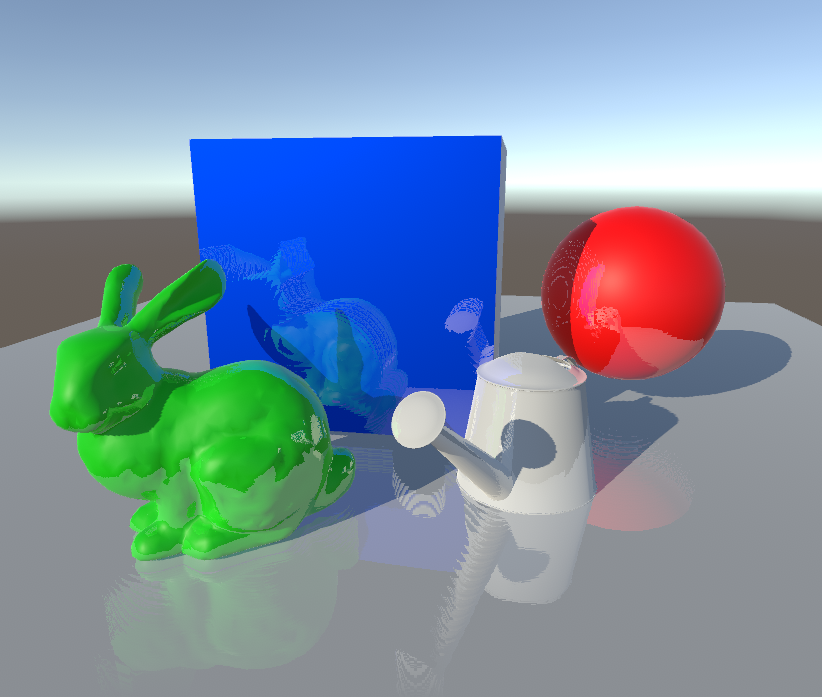
jitter on

画面端のフェード
反射した先の色は、シーンの色情報を元に算出します。つまり、もともとカメラの範囲に入っていないものを反射の色に含めることはできないという欠点があります。 そのためシーンの構成によっては画面の端の反射が違和感に感じる場合があるので、画面の端にいくほど反射をフェードアウトさせるようにしてみます。
            // screen edge fade

            float screenEdgeFadeFactorX = (abs(i.texcoord.x * 2. - 1.) - _ReflectionScreenEdgeFadeFactorMinX) / max(_ReflectionScreenEdgeFadeFactorMaxX - _ReflectionScreenEdgeFadeFactorMinX, eps);
            float screenEdgeFadeFactorY = (abs(i.texcoord.y * 2. - 1.) - _ReflectionScreenEdgeFadeFactorMinY) / max(_ReflectionScreenEdgeFadeFactorMaxY - _ReflectionScreenEdgeFadeFactorMinY, eps);

            screenEdgeFadeFactorX = saturate(screenEdgeFadeFactorX);
            screenEdgeFadeFactorY = saturate(screenEdgeFadeFactorY);

            screenEdgeFadeFactorX = 1. - screenEdgeFadeFactorX * screenEdgeFadeFactorX;
            screenEdgeFadeFactorY = 1. - screenEdgeFadeFactorY * screenEdgeFadeFactorY;
反射距離でのフェード
本来、素材によって映り込みの見た目が変わります。SSRにおいて、反射の範囲が広いと鏡面反射のような素材感に見える場合があるので、ジオメトリの座標とレイの距離に応じてフェードするようにしてみました。
deferredであればsmoothnessなど、マテリアルの素材に関わるようなパラメーターに応じてフェード具合などを調整するなどしてもいいかもしれません。
            float rayWithSampledPositionDistance = distance(viewPosition, sampledViewPosition);
            float distanceFadeRate = (rayWithSampledPositionDistance - _ReflectionFadeMinDistance) / max(
                _ReflectionFadeMaxDistance - _ReflectionFadeMinDistance, eps);
            distanceFadeRate = saturate(distanceFadeRate);
            distanceFadeRate = 1. - distanceFadeRate * distanceFadeRate; // 距離減衰
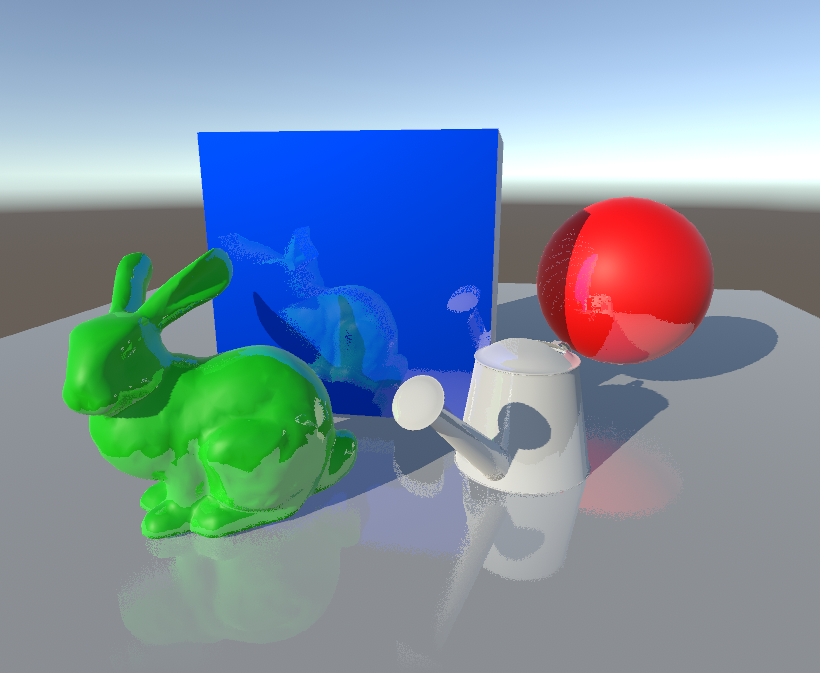
画面端のフェード・反射地点の距離フェードなし
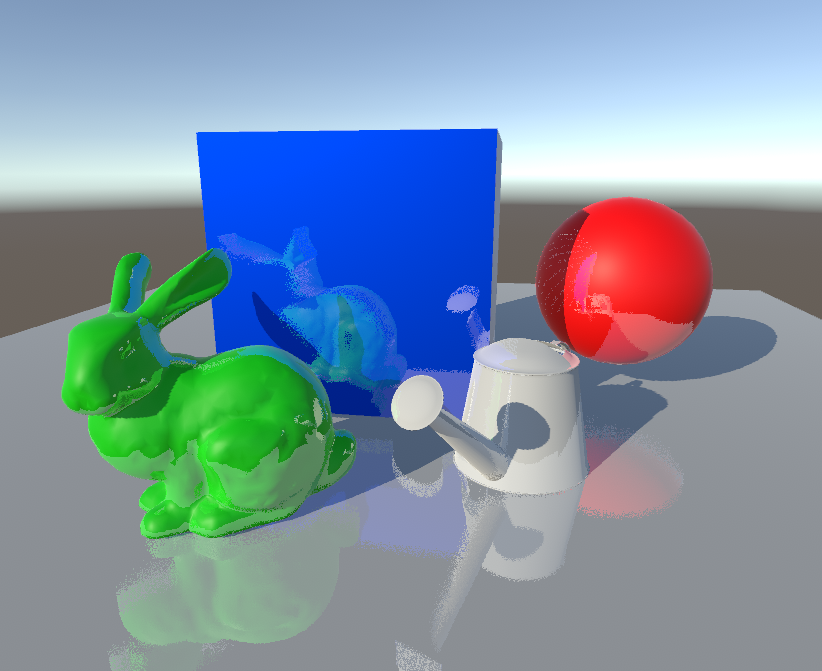
画面端のフェード・反射地点の距離フェードあり
SSRの欠点
ます、高負荷になりがちです。深度、法線情報が必要になり、精度を上げるためにはレイを飛ばす回数を増やす必要があるのが大きな理由です。
見た目的に大きな欠点は「裏側」を描画することができない・画面端のようにもともとカメラに映っていないものは反射に含めることができない、という点です。
裏側に関しては、カメラに映らない裏側が見える位置に別のカメラを置きRenderTextureに描画し、裏側の色を反射した先の色としてみなす場合はそのRenderTextureを参照するという方法も考えられますが、 Screen Space Reflection の基本的な実装部分の負荷がすでに高めになりがちなので、端末スペックやパフォーマンスに余裕があるときでないと採用は難しいはずです。
改善
今回は「ポストプロセスのパス」で計算する方法をとりました。実用をさらに踏まえると、
フル解像度ではなく1/2ぐらいの縮小バッファを使うことによる速度改善
複数フレーム間での平均化やブラーを入れることによる品質改善
が見込めるので、RenderTextureを使って計算する方がよいかもしれません。
参考
https://tips.hecomi.com/entry/2016/04/04/022550
https://zenn.dev/mebiusbox/articles/43ecf1bb12831c
http://www.kode80.com/blog/2015/03/11/screen-space-reflections-in-unity-5/
https://hanecci.hatenadiary.org/entry/20140617/p8
【Unity】Screen Space Ambient Occlusion のカスタムポストプロセスの実装
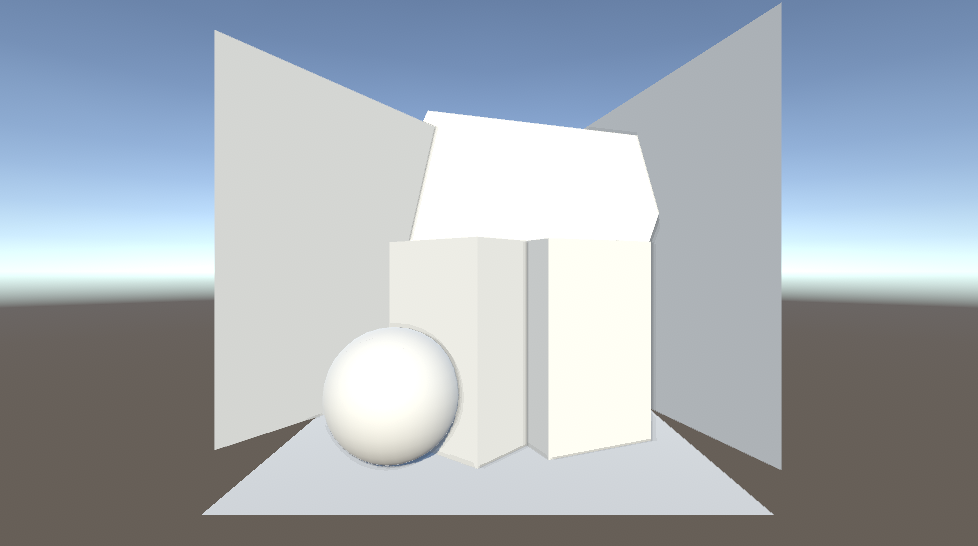
デモのgitはこちらです。
環境はこちらです。
Unity 2021.3.26f built-in pipeline
色も調整できるようにしてみています。

現実とリアルタイムグラフィクスの壁
Ambient Occlusion は直訳すると「環境遮蔽」です。
室内に目を向けると、天井と壁の継ぎ目の隅はちょっと暗くなっています。大雑把な理由は「光が届きにくいから」です。しかしこれがリアルタイムグラフィックスだととても厄介なものになります。
レイトレーシングやいわゆるシェーダー芸のレイマーチングはある程度光学的に正しいアプローチをとることができるので再現しやすいのですが、ラスタライズ手法の Forward Rendering, Deferred Rendering では再現に一苦労します。
それは、 Forward Rendering や Deferred Rendering のライティングは、どちらも基本的には「周囲のオブジェクト」は考慮しないものになっているからです。
forward rendering では一個一個のオブジェクトを塗る時に、そのオブジェクトと光源の情報から色を決定させているからです。deferred rendering はポストプロセス的にG-Bufferを用いてライティングを考慮した色を計算していますが、「周囲のオブジェクト」を考慮しないライティング計算になっている点は同じです。
しかし、直接光がもたらす影など陰影はオブジェクト同士の関係性の認識に大いに役立ちます。近距離にあるオブジェクト同士がもたらす影は、距離感の把握やリアリティさの向上につながります。
SSAO (Screen Space Ambient Occlusion)
そこで登場するのが Screen Space Ambient Occlusion、通称SSAOです。文字の通り、スクリーンスペース(ポストプロセス)のアプローチで環境遮蔽を実現する方法です。
利点は動く物体にも適用できる点です。あらかじめBakeしている必要がありません。
欠点は、品質を求めれば求めるほど負荷が高くなりやすい点です。
その歴史はこちらのリンクがとてもわかりやすいです。ここ十数年ぐらいの話なんですね。
https://ambientocclusion.hatenablog.com/entry/2013/10/15/223302
今回は、3種のSSAOの根本的な実装をやってみました。
- CryEngine2 の SSAO(全球サンプリング)
- StarCraft II の SSAO(半球サンプリング)
- UE4 の SSAO(Angle Based)※ Angle Based という名前が一般的かは不明
今回は実装していないのですが、本来は見た目の品質を綺麗にするためにAmbientOcclusionを計算した後にバイラテラルフィルターなどを使ってエッジのぼかしをかける場合が多いようです(Angled Based の場合はなくてもよい?)。ぼかすことによってAmbientOcclusionが効いているように見える範囲を広げることによって遮蔽の見た目をより強調する、という意味もあるかもしれません。
SSAOの原理的な部分を知りたかったため、ぼかし関連の品質向上的な処理は省いています。
ちなみにぼかし処理は基本的に重くなりやすいです。例えば縦横5px幅ずつのガウシアンブラーフィルターはそれだけで 10 * 2 + 1 = 21回テクスチャサンプリングが走ってしまいます。そのため特にスクリーンスペースでぼかしをかける場合は注意が必要です。
また、「環境遮蔽」なので環境光にたいしてのみAO項を考慮するのが本来は正しいのですが、今回は Forward Rendring での実装なので環境光にのみAO項を作用させるのが難しいため、シーンの色と環境遮蔽によってもたらされる陰の色をブレンドするようにしています。
1. CryEngine2 の SSAO(全球サンプリング)
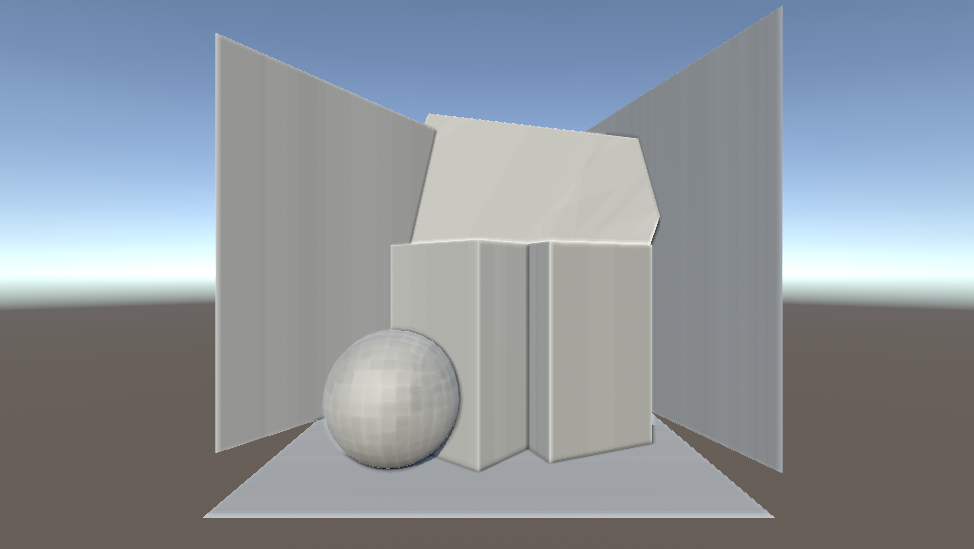
「depth bufferを元に、とある点の周囲にどれぐらい遮蔽するものがあるか」を判断する手法です。
自分はビュー座標系を基準にして実装しました。
- depth buffer を元に、これから描画する点 P のビュー座標系における位置を求める
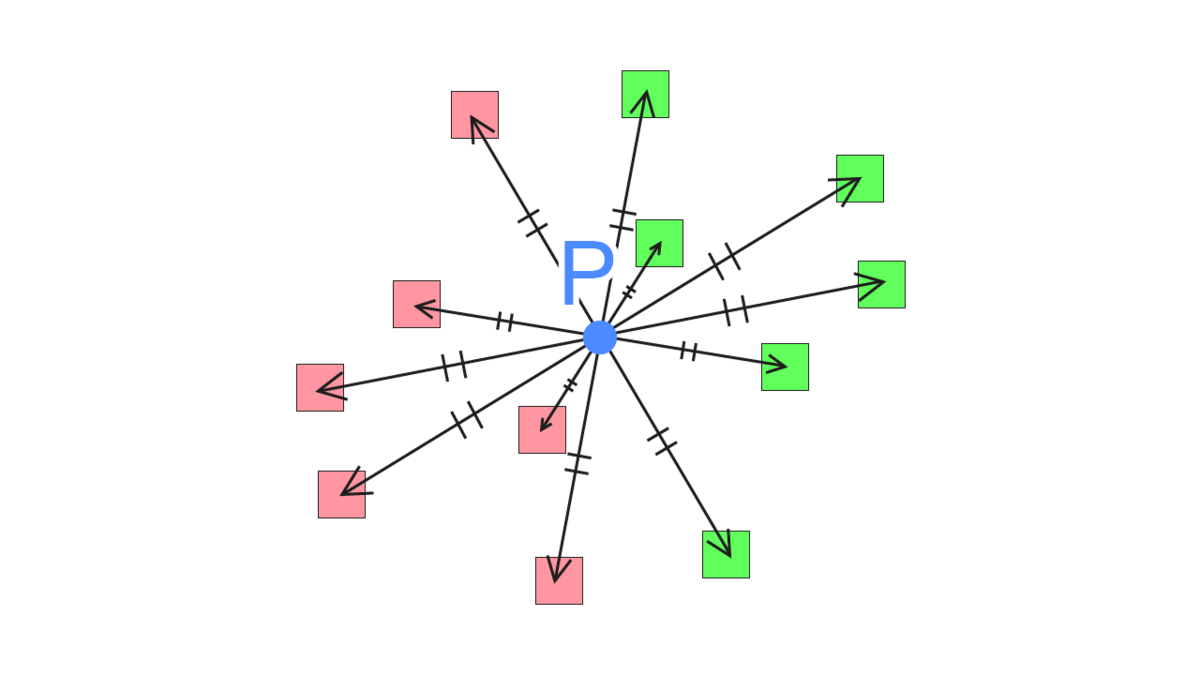
- 点 P から、点 P を中心とする全球内のランダムな点 S のビュー座標を計算
- 点 S の深度値(Sz)と、カメラから見た S の位置の depth buffer の深度値(Sd)を比較
- Sd > Sz なら点 S は遮蔽されているとみなす(ex. 画像の右の点)
- 1~4を指定したサンプル数繰り返し、遮蔽率を計算
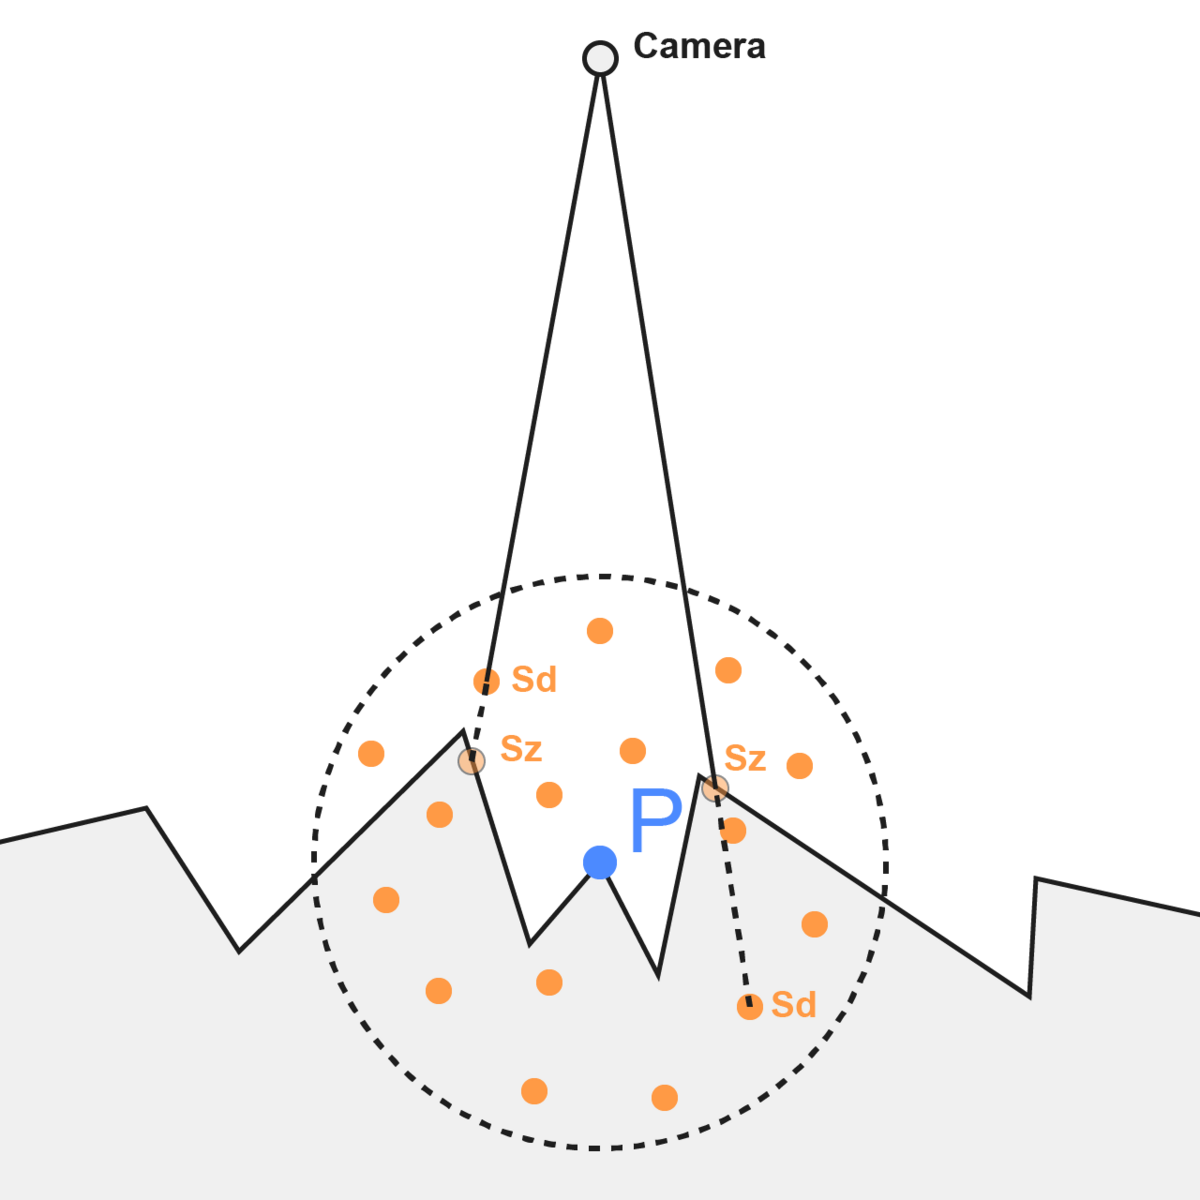
この方法の利点は、depth buffer さえあれば計算可能な点です。
欠点は、必要なサンプリング数が多くなりやすい(無駄なサンプリングが多くなりやすい)点です。今回のようなシンプルなシーンでは64個ぐらいでもある程度それっぽくなるのですが、複雑な形状のシーンの場合はもっとサンプル数が必要になるでしょう。いずれにしても、スペックの低いモバイル端末だとサンプル数64個でも厳しい可能性があります。
また、わりと全体的に暗くなりがちな点も欠点の一つでしょうか。
以下、該当するc#とシェーダーへのリンクです。
https://github.com/takumifukasawa/UnitySSAOBuiltinPipeline/blob/master/SSAO_BuiltinPipeline/Assets/Shaders/SSAO.shader https://github.com/takumifukasawa/UnitySSAOBuiltinPipeline/blob/master/SSAO_BuiltinPipeline/Assets/Scripts/SSAO.cs
実装を一部抜粋しながら見ていきます。
とある点のビュー座標系における位置はdepthから復元することができます。
float3 ReconstructViewPositionFromDepth(float2 screenUV, float depth)
{
    float4 clipPos = float4(screenUV * 2.0 - 1.0, depth, 1.0);
    #if UNITY_UV_STARTS_AT_TOP
    clipPos.y = -clipPos.y;
    #endif
    float4 viewPos = mul(_InverseProjectionMatrix, clipPos);
    return viewPos.xyz / viewPos.w;
}

...

float3 viewPosition = ReconstructViewPositionFromDepth(i.texcoord, rawDepth);
サンプル数分のループ内で、「復元したビュー座標系における位置からランダムにずらした点」のクリッピング座標を求めます。
        for (int j = 0; j < SAMPLE_COUNT; j++)
        {
            float4 offset = _SamplingPoints[j];
            offset.w = 0;

            float4 offsetViewPosition = float4(viewPosition, 1.) + offset * _OcclusionSampleLength;
            float4 offsetClipPosition = mul(_ProjectionMatrix, offsetViewPosition);

            #if UNITY_UV_STARTS_AT_TOP
            offsetClipPosition.y = -offsetClipPosition.y;
            #endif

            float2 samplingCoord = (offsetClipPosition.xy / offsetClipPosition.w) * 0.5 + 0.5;
            float samplingRawDepth = SampleRawDepth(samplingCoord);
            float3 samplingViewPosition = ReconstructViewPositionFromDepth(samplingCoord, samplingRawDepth);

            // 現在のviewPositionとoffset済みのviewPositionが一定距離離れていたらor近すぎたら無視
            float dist = distance(samplingViewPosition.xyz, viewPosition.xyz);
            if (dist < _OcclusionMinDistance || _OcclusionMaxDistance < dist)
            {
                continue;
            }

            // 対象の点のdepth値が現在のdepth値よりも小さかったら遮蔽とみなす(= 対象の点が現在の点よりもカメラに近かったら)
            if (samplingViewPosition.z > offsetViewPosition.z)
            {
                occludedCount++;
            }
        }

        float aoRate = (float)occludedCount / (float)divCount;

        // NOTE: 本当は環境光のみにAO項を考慮するのがよいが、forward x post process の場合は全体にかけちゃう
        color.rgb = lerp(
            baseColor,
            _OcclusionColor.rgb,
            aoRate * _OcclusionStrength
        );
sampling points は c# 側で単位球内にランダムに散らした点群をシェーダーに渡したものです。
static Vector4[] GetRandomPointsInUnitSphere()
{
    var points = new List<Vector4>();
    while (points.Count < SAMPLING_POINTS_NUM)
    {
        var p = UnityEngine.Random.insideUnitSphere;
        points.Add(new Vector4(p.x, p.y, p.z, 0));
    }

    return points.ToArray();
}
2. StarCraft II の SSAO(半球サンプリング)
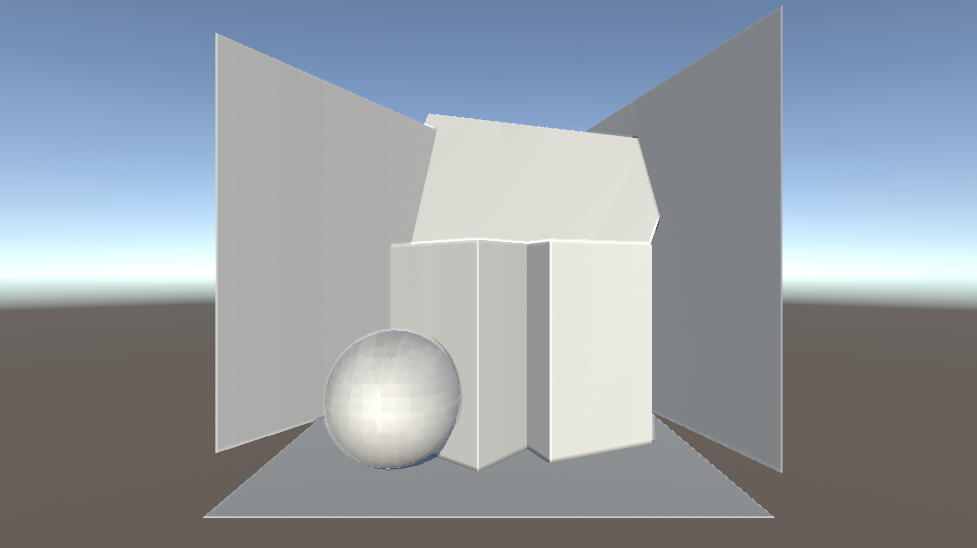
全球サンプリングには無駄な部分があります。それは、法線方向の反対側はジオメトリの内側になっている可能性が高い点です。
そこでサンプリングする点を法線方向を考慮した半球に限定することにより最適化を進めた計算方法になります。
方法は全球サンプリングとほぼ変わりません。サンプルする対象の点が半球内になっただけです。
- depth buffer を元に、これから描画する点 P のビュー座標系における位置を求める
- 点 P から、法線方向の半球内のランダムな点 S のビュー座標を計算
- 点 S の深度値(Sz)と、カメラから見た S の位置の depth buffer の深度値(Sd)を比較
- Sd > Sz なら点 S は遮蔽されているとみなす
- 1~4を指定したサンプル数繰り返し、遮蔽率を計算
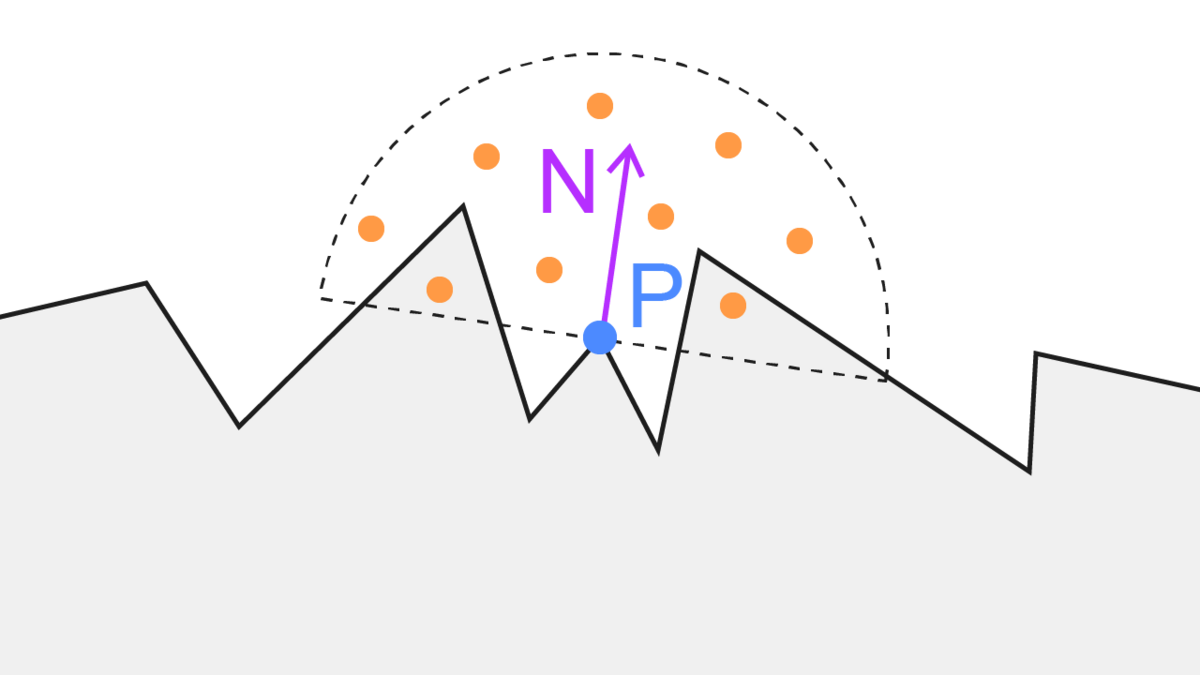
利点はサンプリング回数の無駄が減ったことです。
欠点は法線方向への考慮が必要なので法線情報が格納されたテクスチャが必要になる点です。
Deferred Rendering を使う場合はほとんどの場合で G-Buffer に法線を含めているはずなので「どう用意するか」に関しては特に気にする必要はないのですが Forward Rendering の場合は一工夫必要です。
幸い、Unityには DepthTextureMode で法線が入ったテクスチャを焼くように指定することができます。
camera.depthTextureMode |= DepthTextureMode.DepthNormals;
名前の通り、depthと法線を一つのテクスチャに埋めているようですね。素直に実装すると2パス必要なところ、1パスで2つの情報を入れるようにしてくれているのでこれを使うことにします。
Unity - Scripting API: DepthTextureMode.DepthNormals
以下、該当するc#とシェーダーへのリンクです。
https://github.com/takumifukasawa/UnitySSAOBuiltinPipeline/blob/master/SSAO_BuiltinPipeline/Assets/Shaders/SSAOHemisphere.shader https://github.com/takumifukasawa/UnitySSAOBuiltinPipeline/blob/master/SSAO_BuiltinPipeline/Assets/Scripts/SSAOHemisphere.cs
実装を一部抜粋しながら見ていきます。
まず、半球内にランダムに散らした点を生成します。法線方向への考慮はシェーダー内で行います。
    static Vector4[] GetRandomPointsInUnitHemisphere()
    {
        var points = new List<Vector4>();
        while (points.Count < SAMPLING_POINTS_NUM)
        {
            var r1 = UnityEngine.Random.Range(0f, 1f);
            var r2 = UnityEngine.Random.Range(0f, 1f);
            var x = Mathf.Cos(2 * Mathf.PI * r1) * 2 * Mathf.Sqrt(r2 * (1 - r2));
            var y = Mathf.Sin(2 * Mathf.PI * r1) * 2 * Mathf.Sqrt(r2 * (1 - r2));
            var z = 1 - 2 * r2;
            z = Mathf.Abs(z);
            points.Add(new Vector4(x, y, z, 0));
        }

        return points.ToArray();
    }
法線方向の半球内にランダムにオフセットするために、法線を使った正規直交基底内を利用します。法線マップを実装するときの考え方に近いですね。
法線は _CameraDepthNormalsTexture から取得します。
オフセットする位置を計算したらあとは全球サンプリングと同じ方法になります。
    TEXTURE2D_SAMPLER2D(_CameraDepthNormalsTexture, sampler_CameraDepthNormalsTexture);

...

    float3 SampleViewNormal(float2 uv)
    {
        float4 cdn = SAMPLE_TEXTURE2D(_CameraDepthNormalsTexture, sampler_CameraDepthNormalsTexture, uv);
        return DecodeViewNormalStereo(cdn) * float3(1., 1., 1.);
    }

...

    float3x3 GetTBNMatrix(float3 viewNormal)
    {
        float3 tangent = float3(1, 0, 0);
        float3 bitangent = float3(0, 1, 0);
        float3 normal = viewNormal;
        float3x3 tbn = float3x3(tangent, bitangent, normal);
        return tbn;
    }

...

    float3 viewNormal = SampleViewNormal(i.texcoord);

...

    for (int j = 0; j < SAMPLE_COUNT; j++)
    {
        float3 offset = _SamplingPoints[j];
        offset.z = saturate(offset.z + _OcclusionBias);
        offset = mul(GetTBNMatrix(viewNormal), offset);

...
3. UE4 の SSAO(Angle Based)
SIGGRAPH2012でUE4のデモに関する発表の中で紹介された手法です。
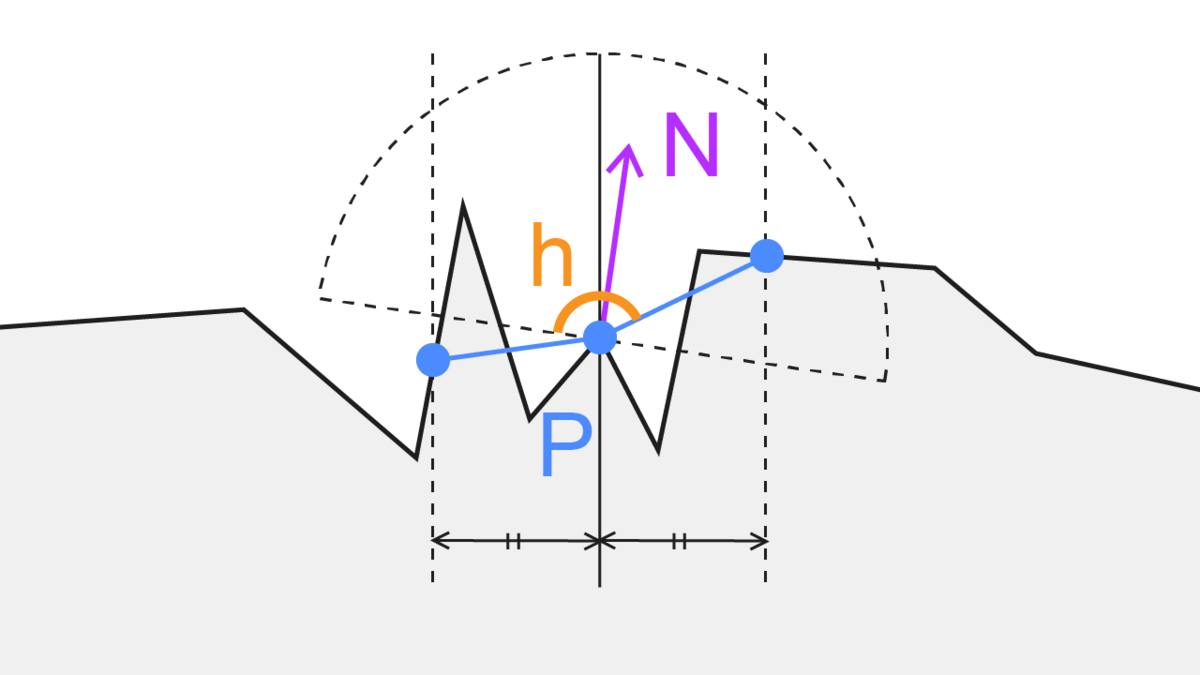
「とある点Pから等距離に伸ばした2点」の位置を計算し、「とある点Pと2点のそれぞれの角度の合計」で遮蔽具合を判断する、という方法です。サンプリング数は6x2で12点を必要としているようです。
つまり、「角度6種と長さ6種の設定」が鍵になります。これをいい具合にばらけさせるなど調整する必要があります。
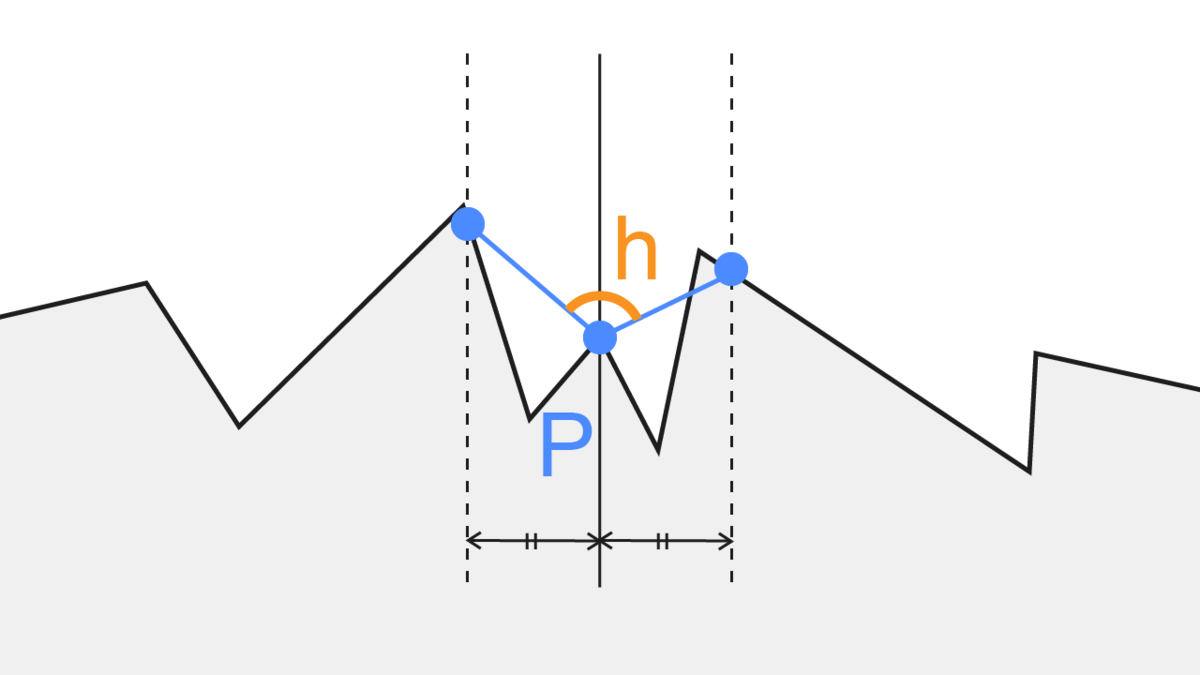
この方法の利点は、AmbientOcclusionの計算に使うテクスチャのサンプル数が最低12回で済むという点です。全球を考慮した方法と比べると大きな差ですね。また、角度を遮蔽度合いとして捉えることができます。つまり、全球/半球サンプリングでは各サンプリング点において「遮蔽されているかどうか」しか判別できなかったのが、「角度の累積でどれぐらい遮蔽されているかの度合い」を考えることができるのでより近い近似になりそうです。また、サンプリング位置をできるだけ散らすために4x4pxの範囲内でさらに回転を加えているようですね。
サンプル数が「最低12回」と書いたのは、ピクセルベースの法線情報(ex. G-Bufferの法線情報やノーマルマップ)を考慮するかどうかでサンプル数が変わるからです。スライドによると法線を考慮したいケースでは法線情報をもとに範囲を限定しつつさらにもう一回遮蔽度合いの計算を行うようです。そのため、サンプル数は計24回になりますね。
(2023.7.17修正) 上の法線方向を考慮した実装に関して改めて資料を読んでいたところ法線を踏まえつつ再度遮蔽度具合の計算を行うのではなく、法線の半球の裏側を隠れているとみなしてclampした角度をAO項の計算に使う、ということのようでした。
以下、該当するc#とシェーダーへのリンクです。
https://github.com/takumifukasawa/UnitySSAOBuiltinPipeline/blob/master/SSAO_BuiltinPipeline/Assets/Shaders/SSAOAngleBased.shader https://github.com/takumifukasawa/UnitySSAOBuiltinPipeline/blob/master/SSAO_BuiltinPipeline/Assets/Scripts/SSAOAngleBased.cs
実装を一部抜粋しながら見ていきます。
まず、c#でサンプリングする角度と距離を6つずつ作成します。
スライドでは角度と長さの情報をテクスチャで渡しているのか、Uniformな配列情報として渡しているのかがわかりませんでした。デモではUniformな配列情報として渡すことにします。
ランタイム実行の度に生成しているのですが、毎回良質なサンプリング点を生成できるとは限らないので、あらかじめ任意の点を設定できるようにする方が実際はよいと思います。
            var rotList = new List<float>();
            var lenList = new List<float>();
            var sampleCount = 6;

            for (int i = 0; i < sampleCount; i++)
            {
                // 任意の角度. できるだけ均等にバラけていた方がよい
                var pieceRad = (Mathf.PI * 2) / sampleCount;
                var rad = UnityEngine.Random.Range(
                    pieceRad * i,
                    pieceRad * (i + 1)
                );
                rotList.Add(rad);

                // 任意の長さの範囲. できるだけ均等にバラけていた方がよい
                var baseLen = 0.1f;
                var pieceLen = (1f - baseLen) / sampleCount;
                var len = UnityEngine.Random.Range(
                    baseLen + pieceLen * i,
                    baseLen + pieceLen * (i + 1)
                );
                lenList.Add(len);
            }

            sheet.properties.SetFloatArray("_SamplingRotations", rotList.ToArray());
            sheet.properties.SetFloatArray("_SamplingDistances", lenList.ToArray());
「とある点Pから等距離に伸ばした2点」の位置を計算し、「とある点Pと2点のそれぞれの角度の合計」で遮蔽具合を判断する計算はこちらになります。
スライドやいろいろな記事を見ると2次元的に角度を計算しているようにみえる(おそらくxyのどちらかの次元を落としている)のですが、自分の実装ではビュー座標系において3次元的に角度を計算しています。
        float occludedAcc = 0.;
        int samplingCount = 6;

        for (int j = 0; j < samplingCount; j++)
        {
            float2x2 rot = GetRotationMatrix(_SamplingRotations[j]);
            float offsetLen = _SamplingDistances[j] * _OcclusionSampleLength;
            float3 offsetA = float3(mul(rot, float2(1, 0)), 0.) * offsetLen;
            float3 offsetB = -offsetA;

            float rawDepthA = SampleRawDepthByViewPosition(viewPosition, offsetA);
            float rawDepthB = SampleRawDepthByViewPosition(viewPosition, offsetB);

            float depthA = Linear01Depth(rawDepthA);
            float depthB = Linear01Depth(rawDepthB);

            float3 viewPositionA = ReconstructViewPositionFromDepth(i.texcoord, rawDepthA);
            float3 viewPositionB = ReconstructViewPositionFromDepth(i.texcoord, rawDepthB);

            float distA = distance(viewPositionA, viewPosition);
            float distB = distance(viewPositionB, viewPosition);

            if (abs(depth - depthA) < _OcclusionBias)
            {
                continue;
            }
            if (abs(depth - depthB) < _OcclusionBias)
            {
                continue;
            }

            if (distA < _OcclusionMinDistance || _OcclusionMaxDistance < distA)
            {
                continue;
            }
            if (distB < _OcclusionMinDistance || _OcclusionMaxDistance < distB)
            {
                continue;
            }

            float3 surfaceToCameraDir = -normalize(viewPosition);
            float dotA = dot(normalize(viewPositionA - viewPosition), surfaceToCameraDir);
            float dotB = dot(normalize(viewPositionB - viewPosition), surfaceToCameraDir);
            float ao = (dotA + dotB) * .5;

            occludedAcc += ao;
        }

        float aoRate = occludedAcc / (float)samplingCount;
今回、遮蔽の度合いはこのように -1 ~ 1 の範囲と捉えて計算しています。プロジェクトごとに調整してよい部分かなと思います。例えば「ちょっとでも角度があったら遮蔽しているとみなしたい」時は 0 ~ 1 の範囲の方が適切です。
            float ao = (dotA + dotB) * .5;

            occludedAcc += ao;
品質を高めたい場合はサンプリング回数を増やしてもよいと思います。作っているものによっては描画処理に余裕がある場合などですね。
実装の改善として、角度と長さはfloatの配列でそれぞれ要素数6になっていますがvector2な配列で[0]に角度, [1]に長さを入れ vector2の要素数6の配列にすると送る配列が一つ減るので節約になりそうですね。
参考
https://zenn.dev/mebiusbox/articles/c7ea4871698ada
https://ambientocclusion.hatenablog.com/entry/2013/11/07/152755
https://marina.sys.wakayama-u.ac.jp/~tokoi/?date=20101122
https://developers.wonderpla.net/entry/2014/01/31/151540
https://inzkyk.xyz/ray_tracing_in_one_weekend/week_3/3_7_generating_random_directions/
